깃 액션 무료 시간은 레포지토리마다 따로 주어지는 게 아니라 조직 전체가 같이 쓰는 형태였습니다. 그 시간이 한 번 바닥나고 나서야, 누가 얼마나 쓰고 있는지 저희가 챙겨 보는 체계가 없었다는 걸 알게 되었습니다. 러너를 저희 EKS로 가져오면서 정한 것들과, 아직 길다고 느끼는 부분까지 정리했습니다.
안녕하세요. NxtCloud FDE/SA 류명재(Jay)입니다. 이번에는 제가 사내 CI 러너를 저희 EKS 클러스터로 가져온 과정에 대해서 설명을 해보려고 합니다. 왜 이걸 하게 되었는지, 그리고 구성하면서 어떤 기준으로 선택했는지를 위주로 정리해봤습니다.
시작하기 전에 범위를 짚어두겠습니다. 이 글은 ARC를 설치하는 방법 자체는 다루지 않습니다. 설치는 공식 문서에 잘 나와 있습니다. 배포 쪽, 그러니까 이미지가 올라간 다음에 ArgoCD가 클러스터에 반영하는 CD 부분도 기존 그대로라서 이 글에서는 빠집니다. 다루는 건 빌드가 돌아가는 자리를 어디로 옮겼는지, 그리고 그 자리를 어떤 규칙으로 운영하게 되었는지입니다.
깃 액션 시간은 조직이 같이 쓰는 지갑이었습니다
저희는 GitHub Actions, 흔히 깃 액션이라고 부르는 걸로 빌드를 하고 있었습니다. 처음에는 레포지토리마다 각자 시간이 있는 줄 알았는데, 확인해 보니 무료 시간은 조직 단위로 주어졌습니다. 저희 조직 플랜 기준으로 한 달에 2,000분이라는 시간을 모든 레포지토리가 같이 나눠 쓰는 형태입니다.[1]
여기에 OS별 배수가 하나 더 붙습니다. 리눅스 러너는 1분을 쓰면 1분이 차감되지만, 윈도우는 2배, 맥은 10배가 차감됩니다. 예를 들어 데스크톱 앱 릴리스처럼 윈도우나 맥 빌드가 필요한 작업이 하나만 붙어도, 공용 시간은 생각보다 훨씬 빠르게 줄어듭니다.
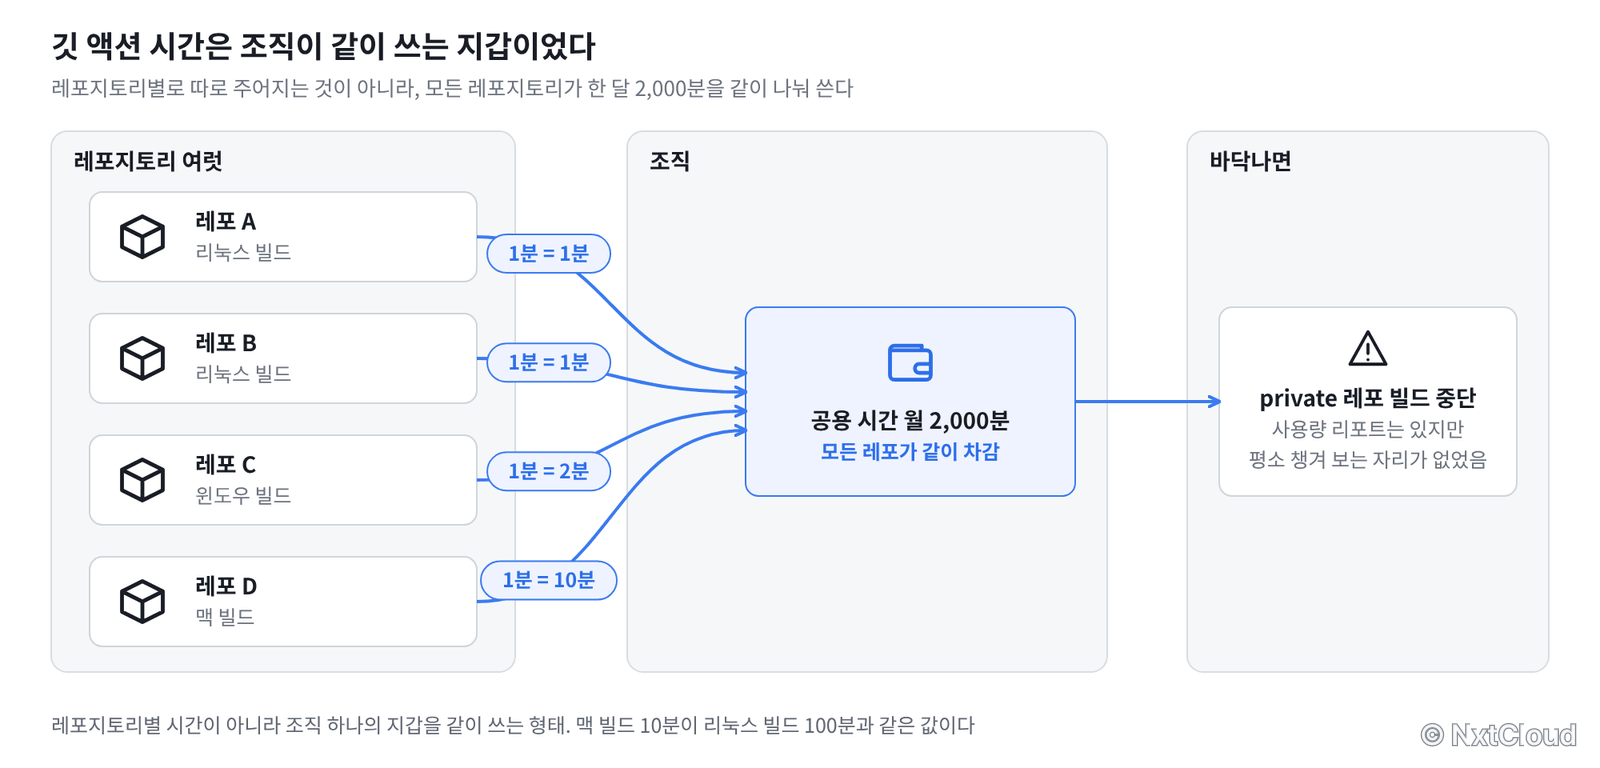 레포지토리별 시간이 아니라 조직 하나의 지갑을 같이 쓰는 형태. 맥 빌드 10분이 리눅스 빌드 100분과 같은 값이다
실제로 이 시간이 바닥난 적이 있었습니다. 그때 저희가 할 수 있었던 건 임시방편뿐이었습니다. 한 프로젝트는 레포지토리를 개인 계정으로 미러링해서 개인 무료 시간으로 빌드를 돌렸습니다. 다행히 그 시점에는 다들 깃 액션을 많이 쓰고 있지 않아서 큰 사고로 이어지지는 않았습니다. 그런데 프로젝트가 늘고 빌드가 늘어날수록, 어느 날 갑자기 모든 레포지토리가 빌드를 못 하는 순간이 올 수 있는 구조입니다. 물론 결제 한도를 올려서 시간을 더 사는 방법도 있습니다. 다만 그건 비용을 더 내고 같은 구조를 유지하는 것이라, 누가 얼마나 쓰는지 모르는 상태는 그대로 남습니다.
그리고 이 일로 더 크게 느낀 점이 하나 있었습니다. GitHub 결제 화면에서 레포지토리별 사용량을 내려받아 볼 수는 있습니다. 하지만 평소에 그걸 챙겨 보는 사람이 없었고, 어떤 레포지토리가 시간을 많이 쓰는지, 어떤 빌드가 자주 실패하는지를 한눈에 보는 자리가 없었습니다. 시간을 늘리는 것만큼이나, 빌드를 저희가 보고 조절할 수 있는 체계가 필요하다고 생각하게 되었습니다.
러너가 저희 밖에 있어서 생기는 문제들
시간 문제를 정리하다 보니, 러너가 GitHub 쪽에 있다는 것 자체에서 오는 문제들도 같이 보였습니다.
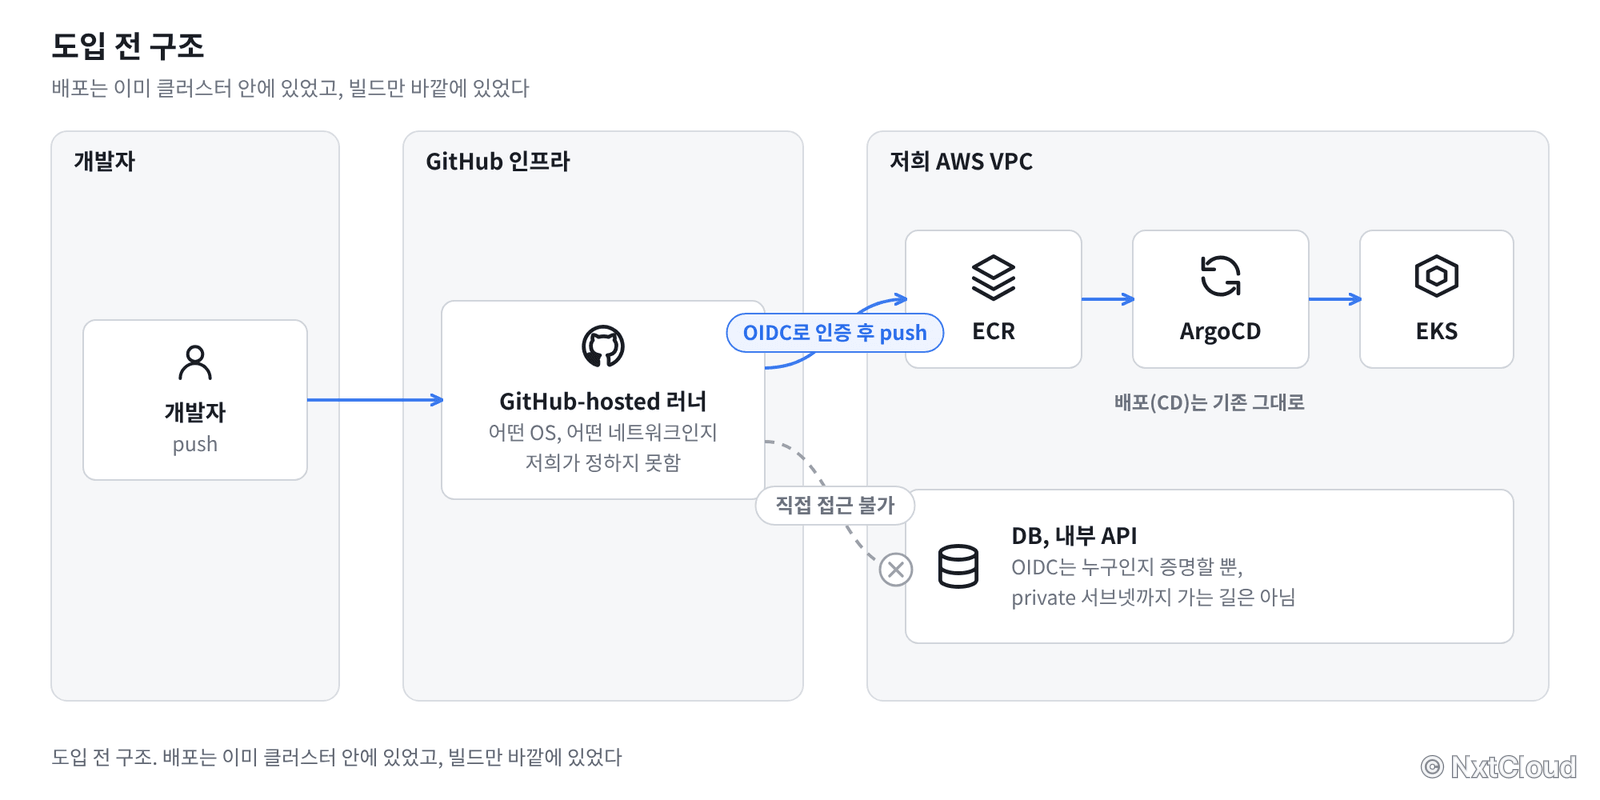 도입 전 구조. 배포는 이미 클러스터 안에 있었고, 빌드만 바깥에 있었다
우선 러너가 저희 VPC 밖에 있다 보니 DB를 붙인 테스트나 내부 API를 호출하는 테스트를 바로 할 수 없습니다. OIDC로 AWS 권한은 받을 수 있지만, 그건 누구인지를 증명할 뿐 private 서브넷까지 가는 길을 열어주지는 않습니다. SSM 포트 포워딩 같은 우회 방법이 있긴 해도, 테스트마다 터널을 붙여야 해서 번거롭습니다. 그 다음에 빌드 환경을 저희가 통제할 수 없습니다. 어떤 OS 이미지에서, 어떤 네트워크를 타고 빌드가 되는지는 GitHub이 정하는 영역입니다. 그리고 빌드 캐시도 GitHub 캐시 스토리지에 기대거나 매번 처음부터 다시 받는 형태였습니다.
보안 쪽에도 고민이 있었습니다. 깃 액션 생태계에서는 Action 태그를 다른 커밋으로 바꿔치기하는 공격이나 워크플로우에서 크리덴셜이 새는 사고 소식이 계속 들려옵니다. 러너를 저희 쪽으로 가져오면 적어도 인증 경로와 실행 환경은 저희가 통제할 수 있는 영역이 됩니다.[2]
후보는 생각보다 빨리 정리됐습니다
GitHub 러너를 그대로 쓰는 것부터 CI 도구를 아예 바꾸는 것까지 몇 가지를 놓고 비교했습니다. CircleCI, TeamCity, Woodpecker, Drone 같은 도구들도 고려 대상에 있었습니다.
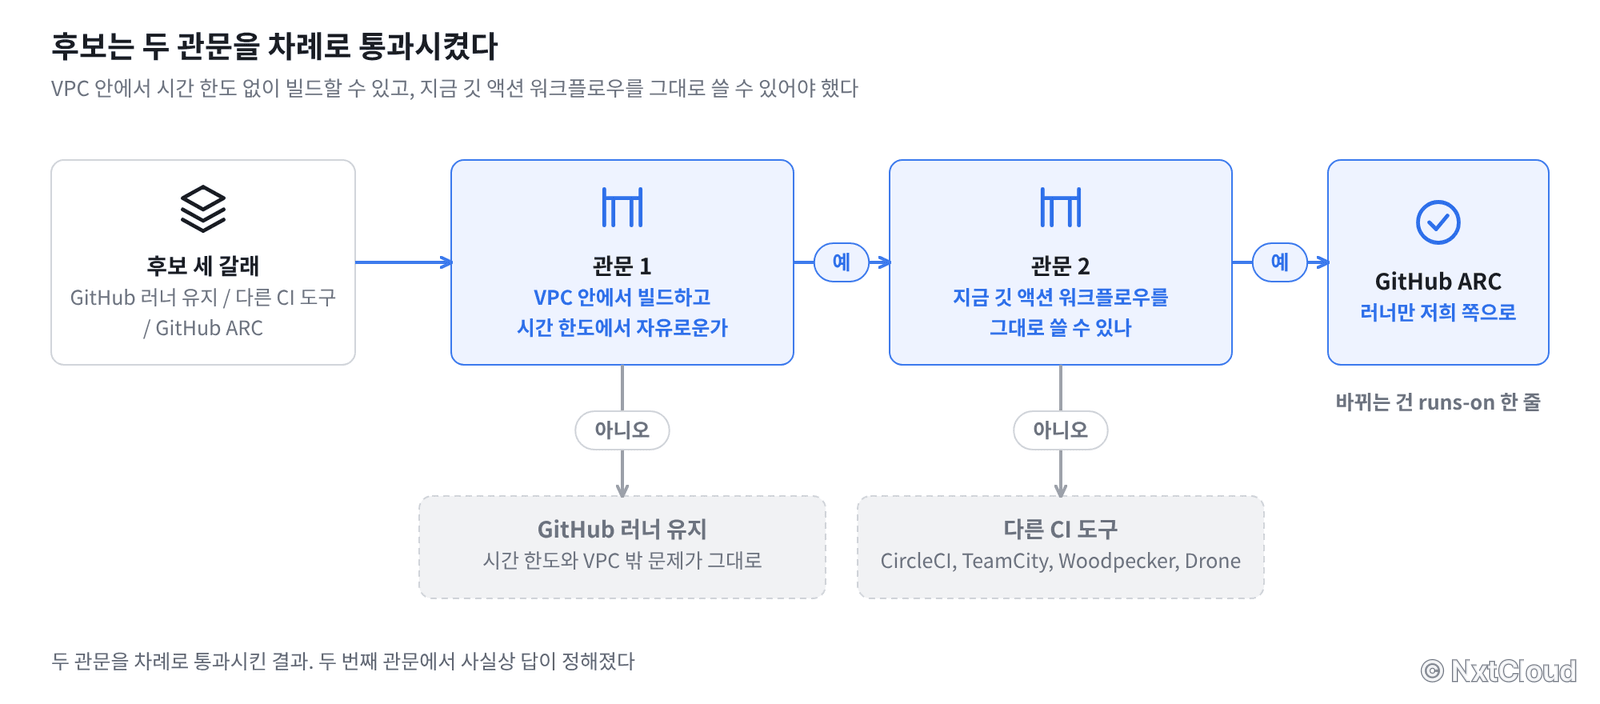 두 관문을 차례로 통과시킨 결과. 두 번째 관문에서 사실상 답이 정해졌다
두 번째 관문이 거의 전부였습니다. 저희는 이미 GitHub으로 코드를 관리하고 있고 워크플로우도 깃 액션으로 짜여 있어서, 도구를 바꾸면 모든 레포지토리의 파이프라인을 다시 써야 하고 운영할 시스템도 하나 더 늘어납니다. 그래서 깃 액션은 그대로 두고, 빌드가 돌아가는 러너만 저희 클러스터로 가져오는 방향이 가장 자연스러웠습니다. 그 역할을 하는 것이 Actions Runner Controller, 줄여서 ARC라는 GitHub 공식 쿠버네티스 컨트롤러입니다.
ARC로 가면 개발자 입장에서 바뀌는 건 기본적으로 워크플로우의 한 줄입니다.
# 변경 전
runs-on: ubuntu-latest
# 변경 후 (러너 스케일 셋 이름, 예시)
runs-on: my-arc-runners
구조는 이렇게 잡았습니다
ARC는 크게 세 가지로 구성됩니다. 리스너는 GitHub에 대기 중인 job이 있는지 계속 물어보면서 러너가 몇 개 필요한지 정하고, 컨트롤러는 그 수에 맞춰 러너 파드를 실제로 만들고 지우며, 러너 스케일 셋은 러너를 최소 몇 개, 최대 몇 개까지 띄울지 정해둔 묶음입니다. 저희는 job 하나가 들어오면 러너 파드 하나가 뜨고, job이 끝나면 그 파드가 바로 사라지는 ephemeral이라는 방식으로 구성했습니다.
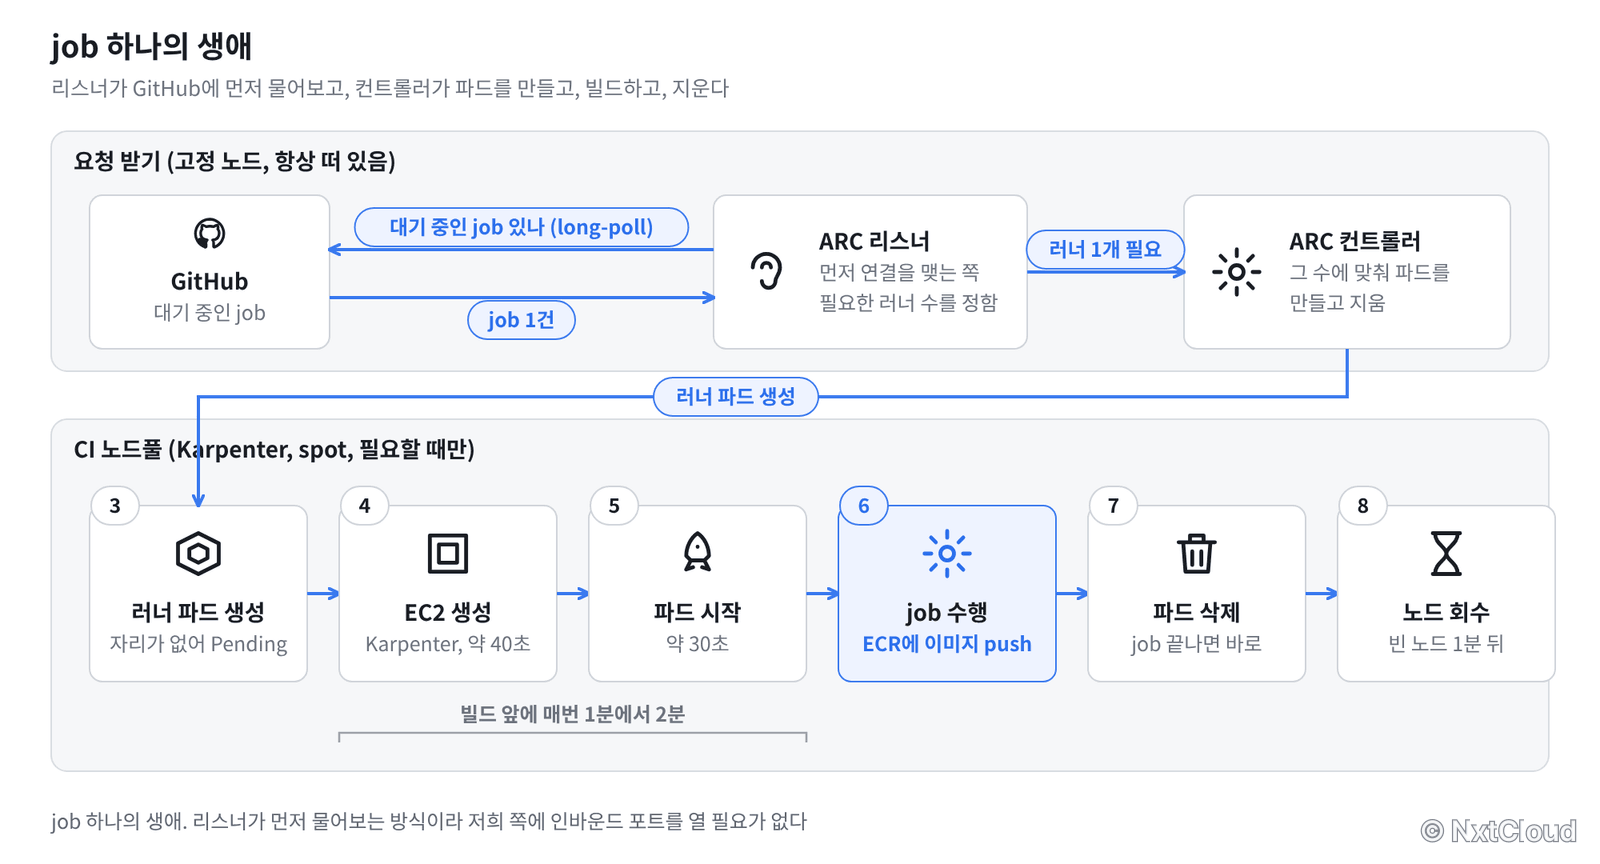 job 하나의 라이프사이클. 리스너가 먼저 물어보는 방식이라 저희 쪽에 인바운드 포트를 열 필요가 없다
여기서 몇 가지를 정했습니다.
리스너가 GitHub으로 먼저 연결을 맺는 long-poll이라는 방식이라, 저희 클러스터에 GitHub이 들어올 구멍을 열어둘 필요가 없습니다. 인증은 개인 토큰(PAT) 대신 GitHub App으로 했습니다. 권한 범위를 러너 관리에 필요한 만큼만 줄 수 있고, 특정 사람 계정에 묶이지 않기 때문입니다.
그리고 ARC 컨트롤러와 리스너는 Karpenter가 관리하지 않는, 항상 떠 있는 노드에 고정했습니다. 컨트롤러가 Karpenter 노드 위에 있으면, 노드가 정리되는 순간 러너를 관리하는 쪽이 같이 사라지는 순환 의존이 생깁니다.
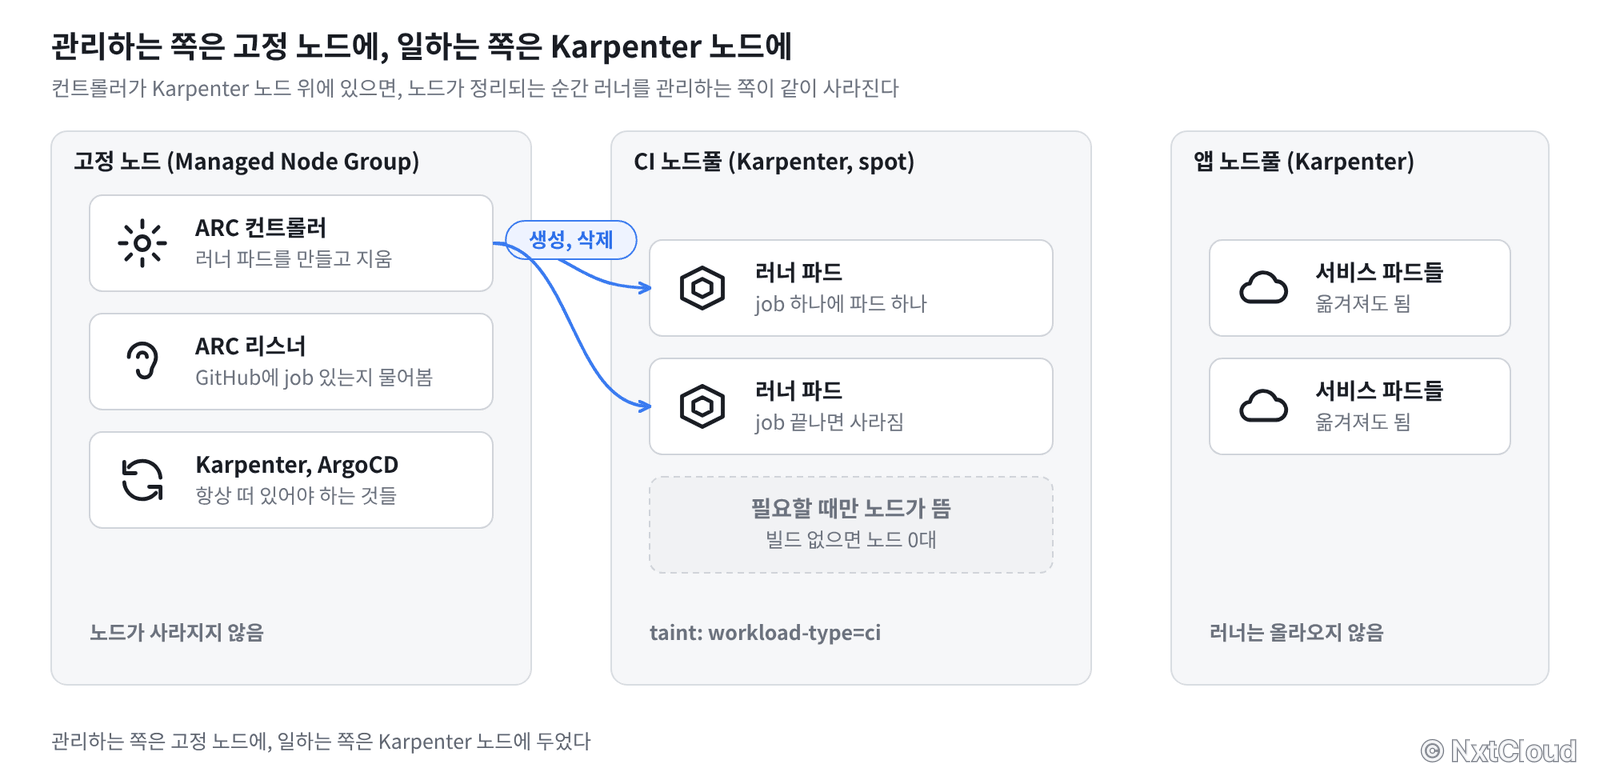 관리하는 쪽은 고정 노드에, 일하는 쪽은 Karpenter 노드에 두었다
빌드는 옮길 수 없는 워크로드입니다
구성하면서 가장 많이 고민한 부분이 여기입니다. 저희 클러스터는 이미 Karpenter라는 노드 오토스케일러로 앱 노드를 관리하고 있었습니다. 그런데 앱 파드에 맞춰진 규칙을 빌드에 그대로 쓸 수는 없었습니다.
앱 파드는 다른 노드로 옮겨져도 됩니다. Deployment가 다른 노드에 새 파드를 띄우면 서비스는 계속됩니다. 하지만 빌드는 옮길 수가 없습니다. 돌고 있던 빌드가 다른 노드로 쫓겨나면 처음부터 다시 해야 하기 때문입니다. 지금 저희 빌드는 몇 분 안에 끝나는 편이지만, 앞으로 Docker 이미지 빌드처럼 수십 분짜리 작업이 붙을 걸 생각하면 이 부분은 처음부터 막아두는 게 맞다고 봤습니다. CI 노드풀의 규칙은 대부분 이 차이에서 나왔습니다.
노드 정리 규칙을 따로 두었습니다
저희 기본 노드풀은 노드가 비었거나 덜 쓰이고 있으면 정리하는 규칙(WhenEmptyOrUnderutilized)을 쓰고 있었습니다. 덜 쓰이는 노드의 파드를 다른 노드로 옮기고 노드를 지워서 비용을 아끼는 방식입니다.
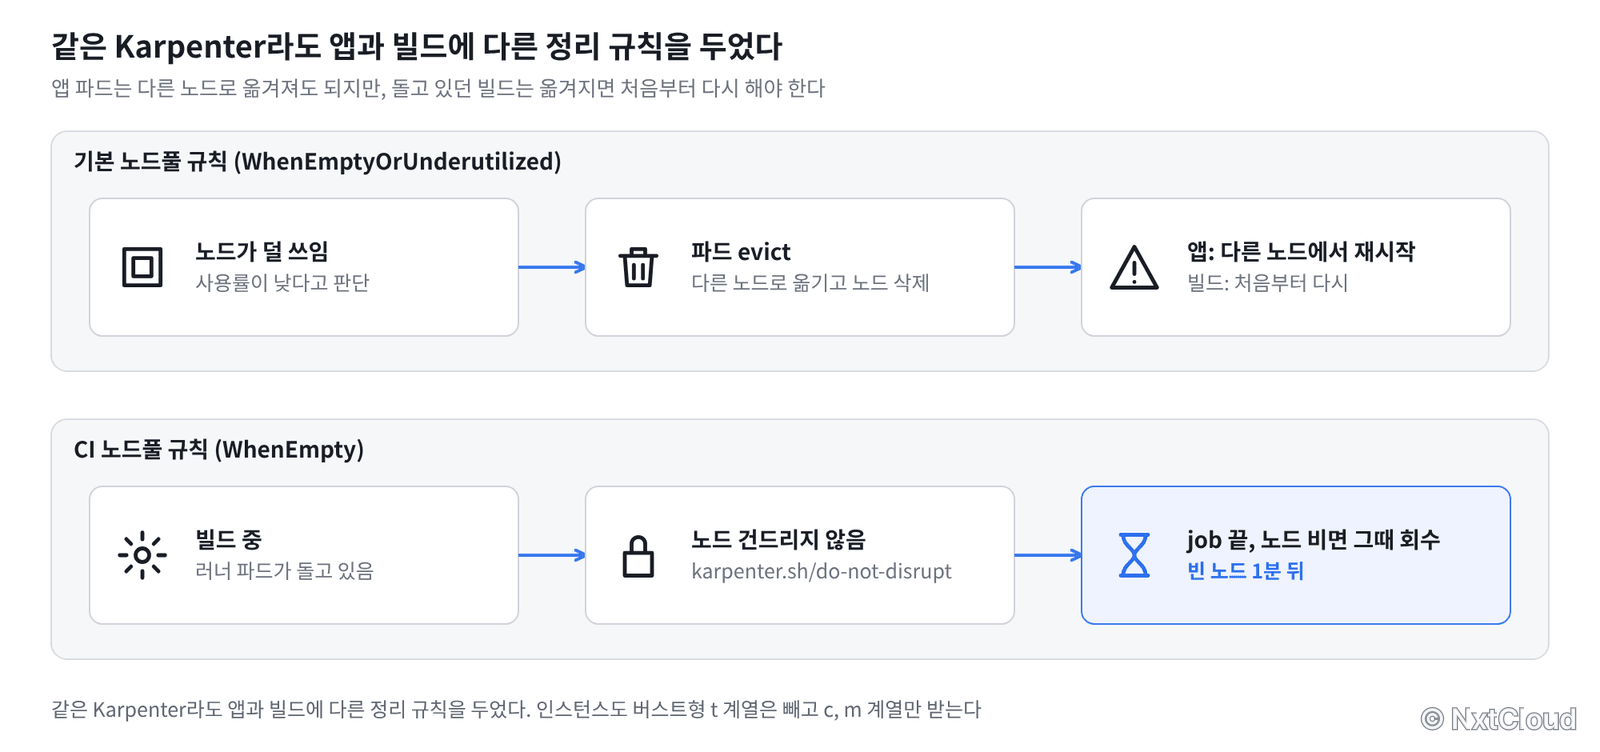 같은 Karpenter라도 앱과 빌드에 다른 정리 규칙을 두었다
CI 노드풀은 노드가 완전히 비었을 때만 정리하는 WhenEmpty로 두고, 러너 파드에는 건드리지 말라는 어노테이션(karpenter.sh/do-not-disrupt)을 한 번 더 걸었습니다. job이 끝나서 파드가 사라지면 노드가 비고, 그때 비로소 노드가 회수되는 흐름입니다. 인스턴스는 빌드처럼 CPU를 꾸준히 쓰는 작업에 맞게 컴퓨팅 최적화(c)와 범용(m) 계열로만 받게 했습니다.
affinity가 아니라 taint로 막았습니다
CI 노드를 따로 만들었다면, 그 노드에는 러너만 올라와야 합니다. 앱 파드가 하나라도 CI 노드에 올라오면 그 노드는 영원히 비지 않고, 비지 않으니 회수도 안 됩니다.
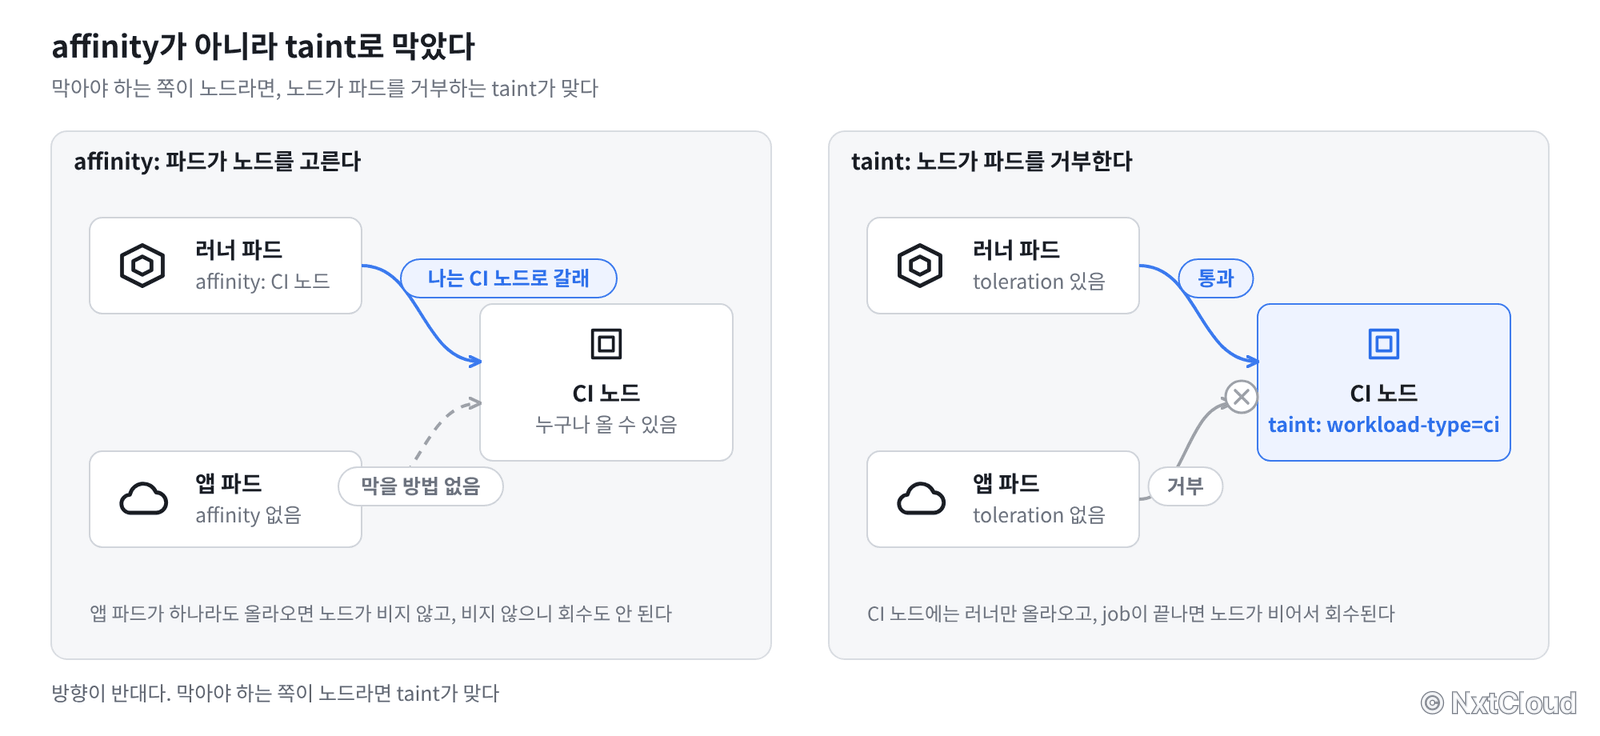 방향이 반대다. 막아야 하는 쪽이 노드라면 taint가 맞다
처음에는 기존 앱들처럼 affinity로 처리하려고 했습니다. 그런데 affinity는 파드가 어느 노드로 가고 싶은지를 말하는 설정이라서, 반대 방향, 그러니까 다른 파드가 CI 노드에 올라오는 걸 막지는 못합니다. 그래서 CI 노드에 taint를 걸고, 러너 파드에만 그 taint를 견디는 toleration을 주는 방식으로 정리했습니다.
처음 옮긴 빌드는 13분이 걸렸습니다
첫 번째로 옮긴 건 사내 문서 사이트의 빌드였습니다. 이 사이트는 원래 AWS Amplify가 빌드부터 호스팅까지 다 맡고 있었는데, 빌드만 ARC로 옮기고 Amplify는 호스팅만 하도록 역할을 나눴습니다. 깃 액션 시간을 쓰던 서비스들은 그 다음 차례로 잡았습니다. 영향이 적은 것부터 옮겨보면서 러너를 먼저 검증하고 싶었기 때문입니다.
그런데 옮기고 나서 처음 돌려보니 배포 한 번에 13분이 걸렸습니다. 예상보다 훨씬 길어서 당황했는데요. 단계별로 시간을 쪼개보니 원인은 빌드가 아니었습니다. ARC 기본 러너 이미지는 GitHub이 운영하는 ubuntu-latest와 달리 거의 빈 이미지입니다. 그래서 워크플로우가 돌 때마다 Node, zip, AWS CLI 같은 도구를 매번 인터넷에서 새로 받아 설치하고 있었습니다.
| 단계 | 기본 이미지 | 커스텀 이미지 |
|---|---|---|
| Node 설정 | 11초 | 1초 |
| zip 설치 | 10초 | 0초 |
| AWS CLI 설치 | 516초 | 단계 삭제 |
| npm ci | 34초 | 35초 |
| 빌드 | 130초 | 132초 |
| 전체 | 약 13분 | 약 3분 40초 |
AWS CLI 설치 하나가 8분 넘게 걸리고 있었습니다. 그래서 자주 쓰는 도구를 미리 넣은 러너 이미지를 따로 만들어 저희 ECR에 올리고, 러너가 그 이미지로 뜨게 바꿨습니다. 빌드 자체(npm ci, 빌드)는 거의 그대로인데 전체 시간이 13분에서 3분 40초로 줄었습니다.
다만 이 숫자는 조심해서 읽어야 합니다. ARC를 도입해서 빌드가 3배 빨라졌다는 뜻이 아니라, ARC로 옮기면서 생긴 지연을 원인을 찾아 되돌린 숫자입니다. 저는 느린 이유가 빌드가 아니라 빌드 전 준비 과정이었다는 걸 단계별 시간을 보고 나서야 알게 된 점이 더 의미가 있었다고 생각합니다.
이미지를 바꿀 때 하나 조심한 점이 있습니다. 러너 설정은 ArgoCD가 main 브랜치를 기준으로 자동 반영하기 때문에, 새 이미지 태그가 담긴 설정이 이미지보다 먼저 main에 들어가면 없는 이미지로 러너가 뜨면서 모든 레포지토리의 CI가 같이 멈춥니다. 그래서 이미지를 먼저 ECR에 올리고 태그가 있는 걸 확인한 다음에 설정을 머지하는 순서로 고정했습니다.[3]
대시보드를 붙이고 나서 보인 것
러너는 job마다 생겼다 사라지기 때문에, 자원을 얼마나 쓰는지가 그냥은 잘 안 보입니다. 그래서 러너 파드와 CI 노드의 사용량, 어떤 인스턴스 타입이 떴는지를 보는 러너 전용 대시보드를 따로 만들었습니다. 처음 문제였던 "보이지 않는다"를 채우는 첫 단계이기도 합니다.
대시보드로 확인해 보니 러너 파드는 CPU를 0.5코어 요청하고 있었는데, 실제로는 최대 1.96코어를 쓰고 있었습니다. 요청의 4배 정도입니다.
 대시보드에 찍힌 러너 job 두 건. 최대 1.96코어, 평균도 1.2코어 안팎으로 요청량 0.5코어를 크게 넘는다
| 항목 | 요청(request) | 실사용 최대 |
|---|---|---|
| CPU | 0.5 core | 1.96 core |
| 메모리 | 1 GiB (상한 4 GiB) | 2.35 GiB |
Karpenter는 실제 사용량이 아니라 파드가 요청한 양을 보고 노드 크기를 정합니다. 처음에는 요청량을 0.5코어로 최소한만 잡고 시작했고, 그에 맞춰 가장 작은 2코어 노드가 떴습니다. CPU 상한(limit)은 두지 않아서 러너는 그 노드의 CPU를 최대 1.96코어까지 썼습니다.[4] 커스텀 이미지 이후에도 npm ci와 빌드가 로컬 PC보다 느린 편인데, 2코어 노드에서 돌고 있는 것과 이어져 있다고 보고 있습니다. 최소 사양으로 실사용량을 확인했으니, 다음 단계는 요청량을 실사용 근처로 올려 더 큰 노드에서 돌려 보는 최적화입니다.
아직은 길다
솔직하게 말하면 저는 3분 40초도 길다고 생각합니다. 이 시간 안에는 빌드만 있는 게 아니라, Karpenter가 노드를 새로 만들고 그 위에 러너 파드가 뜨는 시간까지 같이 들어가 있습니다. 빌드가 없을 때 비용을 0으로 두려고 대기 러너를 0개로 운영하고 있기 때문입니다.
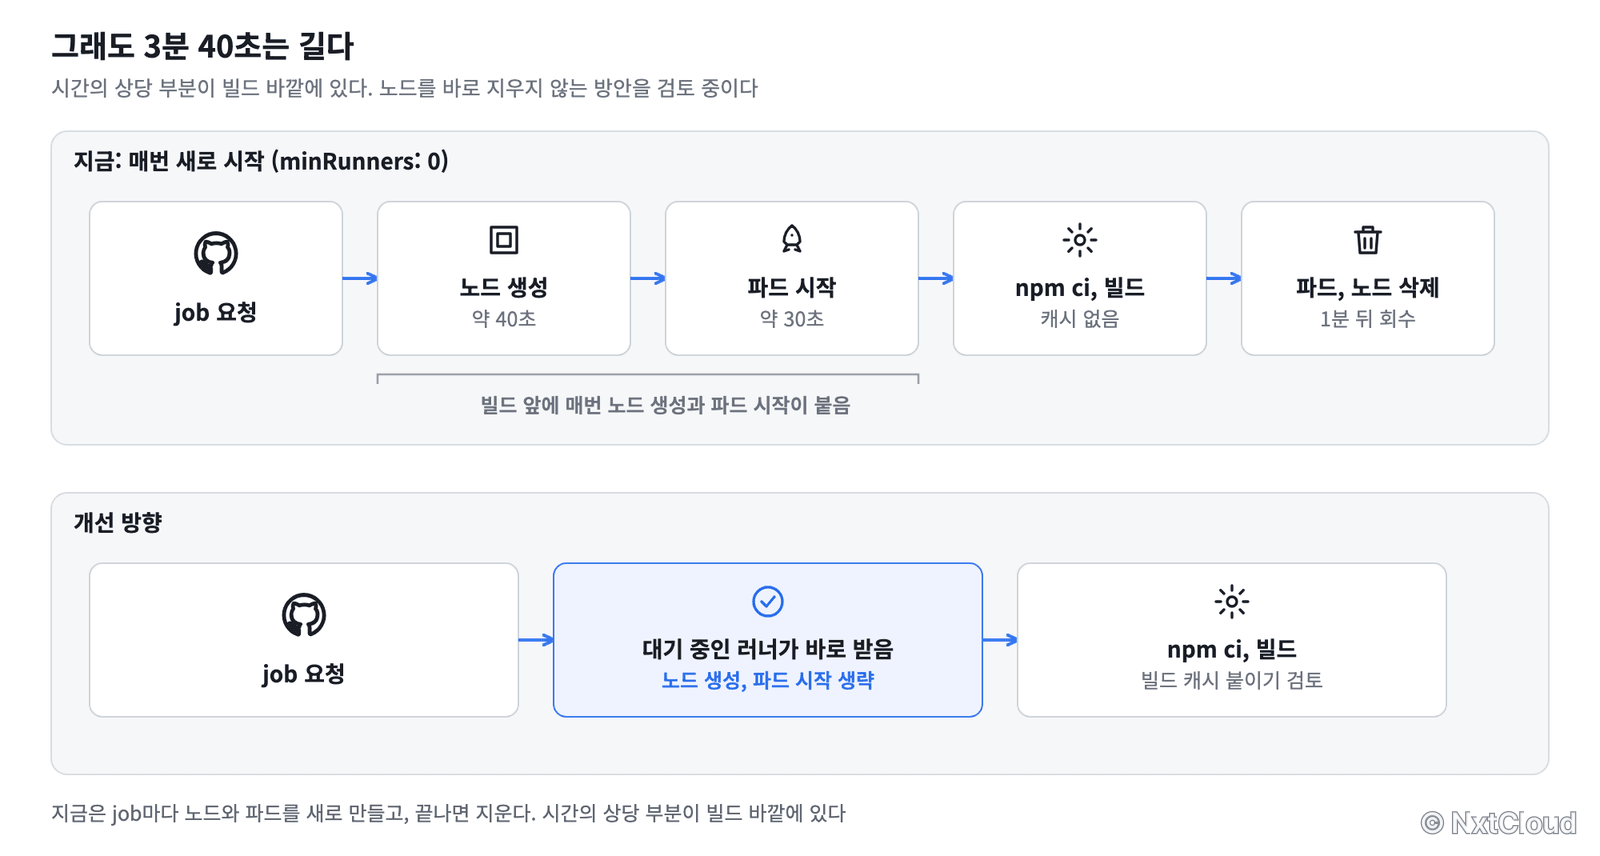 지금은 job마다 노드와 파드를 새로 만들고, 끝나면 지운다. 시간의 상당 부분이 빌드 바깥에 있다
실제로 써 보니 이 대기 시간이 불편한 편입니다. 그래서 노드를 바로 지우지 않고 남겨두는 방법이나 빌드 캐시를 붙이는 방법을 앞으로의 개선 사항으로 생각하고 있습니다. 다만 아직 어떻게 하겠다고 정한 단계는 아니고, 쓰는 레포지토리가 더 늘어나면 그때 비용과 같이 놓고 판단하려고 합니다.
러너를 VPC 안에 두면 통신비도 손볼 수 있습니다
러너를 저희 VPC로 가져오면서 같이 보게 된 점이 하나 더 있습니다. 러너는 private 서브넷에 있어서, AWS 서비스를 부를 때 기본적으로 NAT 게이트웨이를 지나 나갔다가 다시 AWS로 들어옵니다. NAT는 지나가는 데이터 GB당 처리 요금이 붙습니다.
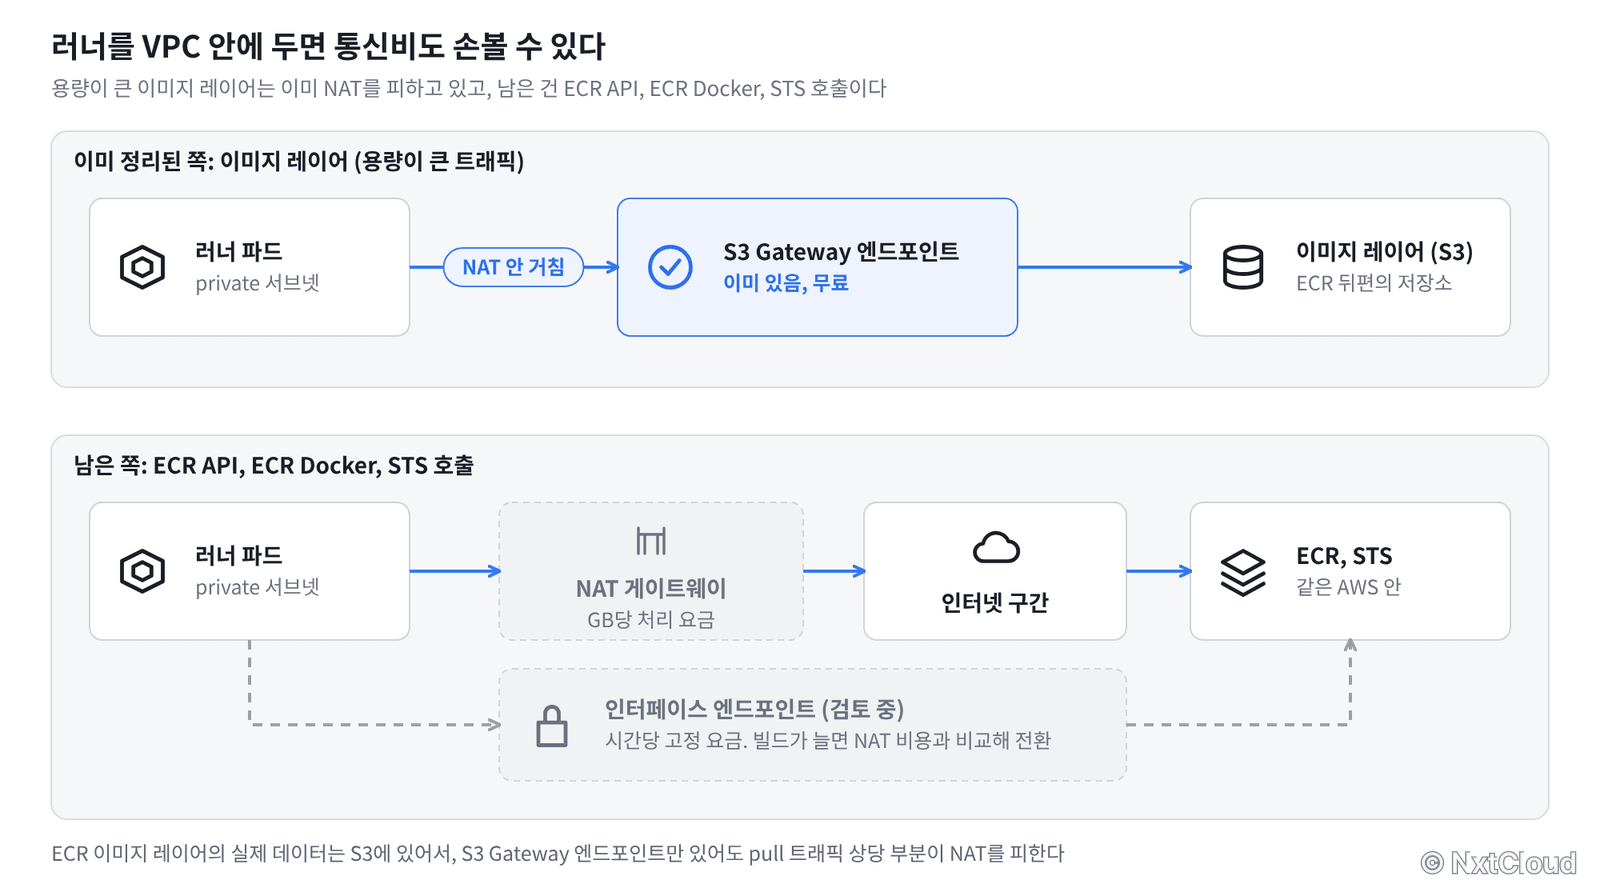 ECR 이미지 레이어의 실제 데이터는 S3에 있어서, S3 Gateway 엔드포인트만 있어도 pull 트래픽 상당 부분이 NAT를 피한다
다행히 용량이 큰 쪽은 이미 정리되어 있습니다. 컨테이너 이미지를 이루는 레이어는 ECR 뒤편의 S3에 저장되는데, 저희 VPC에는 S3 Gateway 엔드포인트가 있어서 이 트래픽은 NAT를 거치지 않습니다. 남은 건 ECR API, ECR Docker, STS 호출입니다. 이쪽도 인터페이스 엔드포인트를 두면 AWS 내부로만 흐르게 할 수 있지만, 시간당 고정 요금이 붙어서 트래픽이 적은 지금은 NAT가 더 쌀 수 있습니다. 빌드가 더 늘어나면 비용을 비교해서 바꿀 예정입니다.
왜 이렇게 골랐는지
구축하면서 막혔던 지점들도 물론 있었습니다. 다만 대부분은 설정을 고치면 끝나는 문제였기 때문에, 이 글에서는 그보다 각 지점에서 왜 이쪽을 골랐는지를 정리해두는 게 더 쓸모가 있을 것 같습니다.
| 선택 지점 | 고른 것 | 대신 고려한 것 | 이유 |
|---|---|---|---|
| ARC 모드 | 러너 스케일 셋 | 구버전 RunnerDeployment | GitHub이 현재 지원하는 방식이고, 구버전은 레거시로 분류됨 |
| 인증 | GitHub App | 개인 토큰(PAT) | 권한 범위를 좁힐 수 있고 사람 계정에 묶이지 않음 |
| 러너 수명 | job 하나에 파드 하나 | 상주 러너 | job 사이에 상태나 크리덴셜이 남지 않음 |
| 노드 | 전용 노드풀, taint, spot | 앱 노드풀 공유 | 빌드 중 evict 방지, 빈 노드 회수 |
| 대기 러너 | 0개 | 1개에서 2개 | 처음에는 비용 0을 우선함. 개선 사항으로 고려 중 |
| Docker 빌드 | DinD | Kaniko, BuildKit | 기존 워크플로우를 고치지 않고 시작하기 위해 |
| ECR 인증 | 기존 OIDC 유지 | IRSA로 바로 전환 | 레포지토리 쪽 변경을 최소화 |
| 레지스트리 인증 위치 | 워크플로우 | 러너에 권한 부여 | 한 레포의 권한이 다른 레포 빌드에 새지 않게 |
| OS | 리눅스 빌드만 ARC로 | 윈도우, 맥도 이전 | 저희 클러스터는 리눅스 노드만 운영하고, 맥은 쿠버네티스 노드로 쓸 수 없음 |
마지막 줄은 처음 문제로 다시 돌아가는 부분입니다. 윈도우나 맥 빌드는 저희 클러스터로 옮길 수가 없습니다. 하지만 리눅스 빌드를 저희 쪽으로 빼두면, 앞으로 윈도우나 맥 빌드가 붙더라도 공용 시간을 그쪽에 남겨둘 수 있습니다. 시간이 가장 비싸게 차감되는 빌드를 위해서 공용 지갑을 비워두는 효과입니다.
대신 내준 것
정직하게 적자면 이 구성이 싸지는 않습니다. 빌드가 없으면 노드 비용은 0이지만, 대기 러너를 두게 되면 그 비용이 더해지고, 앞에서 본 통신비나 러너를 운영하는 사람의 시간도 비용입니다. 소규모 팀 기준으로는 GitHub 러너를 그냥 쓰는 것과 비슷하거나 조금 더 나올 수 있습니다. 그래서 저는 이 구성의 가치가 비용 절감이 아니라 통제에 있다고 봅니다. 빌드가 VPC 안에서 돌고, 사용량이 저희 대시보드에 보이고, 환경을 저희가 정할 수 있다는 점입니다.
보안 쪽에도 내준 게 하나 있습니다. Docker 이미지를 빌드하기 위해서 러너 옆에 DinD(Docker in Docker) 컨테이너를 privileged로 띄우고 있는데, 이건 사실상 노드의 root 권한과 같습니다.[5] 그래서 CI 노드를 앱 노드와 taint로 분리해 두고, CI 노드의 메타데이터 접근 홉 제한(IMDS hop limit)을 1로 걸어서 DinD 안의 컨테이너가 노드의 IAM 자격 증명을 꺼내 쓰지 못하게 막아두었습니다. 그리고 이 러너는 사내 private 레포지토리 전용으로 쓰는 걸 원칙으로 두고 있습니다. public 레포지토리에 연결하면 외부에서 보낸 PR 코드가 저희 VPC 안에서 실행될 수 있기 때문입니다.
지금 어디까지 왔나
솔직하게 적으면 아직 첫 단계입니다. 지금 ARC로 옮겨서 실제로 돌고 있는 건 사내 문서 사이트 빌드 하나이고, 깃 액션 시간을 쓰던 서비스들은 차례로 옮길 예정입니다. 그래서 공용 시간이 실제로 얼마나 아껴지는지는 아직 숫자로 말할 단계가 아닙니다.
앞으로 해볼 것들은 이 정도입니다. 깃 액션 시간을 쓰던 서비스들을 옮기는 일, 대기 러너와 캐시로 체감 시간을 줄이는 일, VPC 엔드포인트로 통신비를 정리하는 일, 레포지토리별 사용 시간과 실패율을 대시보드에 같이 올리는 일, 그리고 DinD를 rootless 빌드로 바꾸는 일입니다.
정리하면
이번 작업은 깃 액션 시간이 바닥난 일에서 시작했지만, 하다 보니 더 중요했던 건 빌드를 저희가 볼 수 있게 된 점이었던 것 같습니다. 깃 액션 시간이 조직 전체의 공용 지갑이라는 것도, 옮긴 빌드가 13분 걸린 이유가 빌드가 아니었다는 것도, 그걸 고친 3분 40초가 아직 길다는 것도 모두 숫자를 보고 나서야 알았습니다.
그리고 Karpenter 같은 오토스케일러 위에 빌드를 올릴 때는, 빌드가 옮길 수 없는 워크로드라는 걸 먼저 놓고 규칙을 짜는 게 맞다고 생각하게 되었습니다. 정리 규칙, taint, 요청량이 전부 그 한 가지에서 나왔습니다.
여기까지가 저희가 깃 액션 시간이 바닥난 일에서 시작해서 러너를 저희 EKS로 가져오게 된 과정이었습니다. 읽어주셔서 감사합니다.
주석
[1] GitHub Actions의 무료 시간과 OS별 차감 배수(리눅스 1배, 윈도우 2배, 맥 10배)는 GitHub 요금 정책에 따라 바뀔 수 있는 값입니다. 도입 시점에 GitHub 공식 요금 문서를 다시 확인하시는 게 좋습니다. public 레포지토리는 GitHub 러너 사용이 무료라서 이 문제는 private 레포지토리에 해당합니다.
[2] self-hosted 러너가 모든 공급망 위험을 막아주지는 않습니다. 외부 Action은 태그 대신 커밋 SHA로 고정해야 하고, 개발자 단말의 크리덴셜 관리는 인프라와 별개의 영역입니다. 저희는 사내 가이드에서 외부 Action을 SHA로 고정하도록 안내하고 있습니다.
[3] 이미지 태그는 커밋 SHA가 아니라 Dockerfile 내용의 해시로 붙였습니다. Dockerfile이 바뀌지 않은 커밋에서는 같은 태그가 나와서, 불필요하게 이미지를 다시 빌드하지 않게 됩니다.
[4] Karpenter는 스케줄링이 안 된 파드들의 요청량(requests)을 합쳐서 그걸 담을 수 있는 가장 싼 인스턴스를 고릅니다. 요청량이 실사용보다 작으면 노드가 작게 잡히고, 같은 노드에 job이 여러 개 몰리면 서로 CPU를 뺏게 됩니다.
[5] privileged 컨테이너는 호스트의 장치와 커널 기능에 거의 제한 없이 접근할 수 있습니다. 그래서 그 컨테이너 안에서 실행되는 코드가 노드 전체에 영향을 줄 수 있습니다. DinD가 Docker 데몬을 띄우려면 이 권한이 필요합니다.
참고
- Actions Runner Controller, GitHub Docs
- Karpenter Disruption (Consolidation, do-not-disrupt), Karpenter Docs
- About billing for GitHub Actions, GitHub Docs
- Security hardening for GitHub Actions, GitHub Docs
- Amazon ECR interface VPC endpoints (AWS PrivateLink), AWS Docs
이 글의 수치와 구성은 실제 운영 과정에서 확인한 것입니다. 사내 레포지토리 이름, 계정 정보, 내부 대역은 익명화했습니다.