온프렘 방화벽에 등록할 저희 측 IP는 하나여야 하고, 온프렘 서버에는 아무것도 설치할 수 없었습니다. 요구사항은 다섯 줄이었는데 읽고 나니까 선택지가 거의 없었습니다. WireGuard를 뜯어보고 Tailscale하고 Cloudflare ZTNA를 각각 실증한 뒤에 도구를 갈아탄 과정을 정리했습니다.
안녕하세요. NxtCloud FDE/SA 류명재(Jay)입니다. 이번에는 제가 고객사 망에 접근하는 원격접속 구성에 대해서 좀 설명을 해보려고 합니다. 저희가 어떤 방식으로 목표를 달성했는지, 그리고 그 과정에서 좀 알게 된 부분들을 정리해봤습니다.
시작하기 전에 하나만 좀 짚어두겠습니다. 이 글은 흔히 말하는 사내 VPN, 그러니까 직원이 회사 망으로 들어오는 그런 구성을 다루지는 않습니다. 저희 문제는 방향이 반대였거든요. 저희가 고객사 망으로 들어가야 했고, 고객사는 저희 쪽 IP를 하나만 열어줄 수 있었고, 고객사 서버에는 아무것도 설치를 할 수가 없었습니다. 이 세 가지가 겹치다 보니까 사내 VPN의 정석이 그대로 적용이 안 됩니다. 그 차이에서 이제 이 글의 모든 선택이 출발을 합니다. 다만 골격이 겹치긴 합니다. 개인 PC에서 중간 박스까지는 어차피 VPN 터널이고, 그 박스 뒤를 저희 사내망으로 바꾸면 같은 구성이 사내 VPN이 되는 형태입니다. 방향이라든지 제약이 다를 뿐입니다.
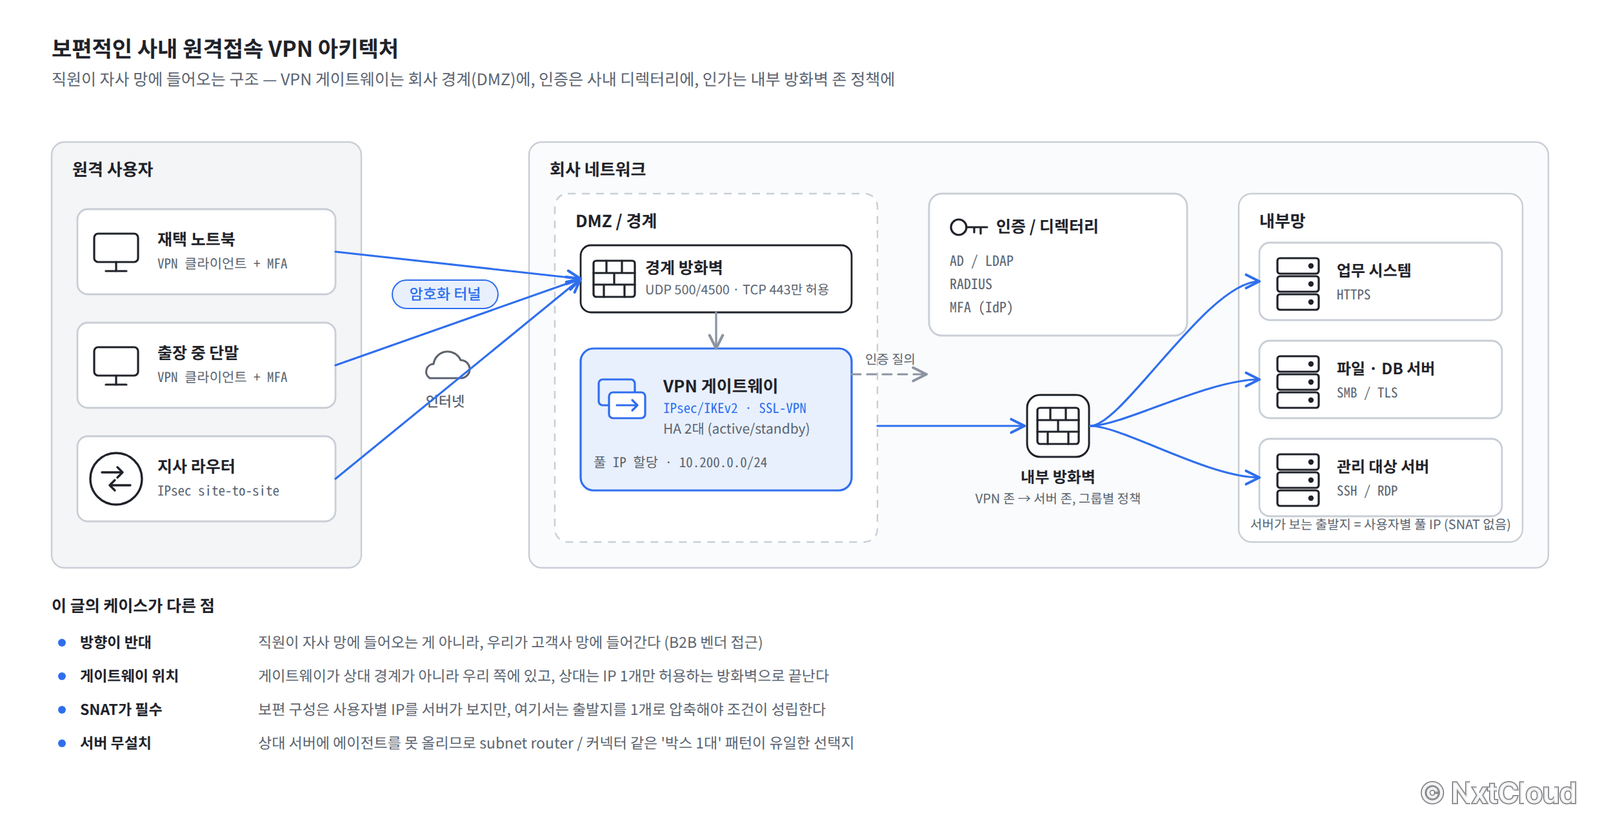 보편적인 사내 원격접속 VPN 아키텍처. VPN 게이트웨이가 회사 경계 DMZ에 있고, 인증은 AD/RADIUS/MFA에, 인가는 내부 방화벽 존 정책에 맡긴다. 아래에 이 글의 케이스가 다른 점 네 가지를 함께 적었다
보편적인 사내 VPN 구성과, 이 글의 케이스가 그것과 다른 네 가지 지점
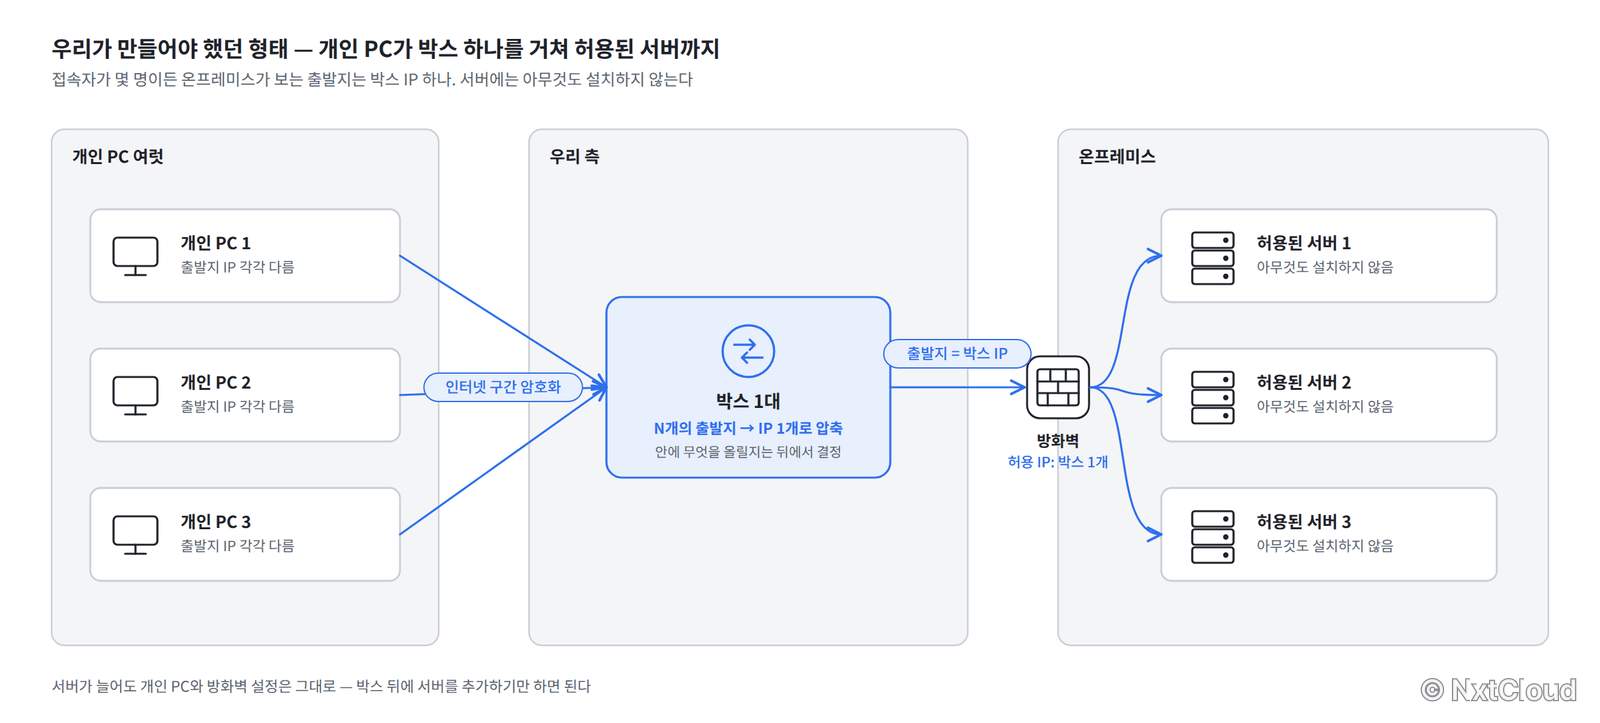 개인 PC 여럿이 우리 측 박스 한 대를 거쳐 온프레미스의 허용된 서버까지 도달하는 목표 형태. 방화벽은 박스 IP 하나만 허용하고 서버에는 아무것도 설치하지 않는다
우리가 만들어야 했던 형태. 박스 안에 무엇을 올릴지는 아직 정하지 않았다
요구사항은 다섯 줄이었습니다
한 대학 고객사의 온프레미스 서버에 접근을 해야 했습니다.
| # | 조건 | 의미 |
|---|---|---|
| 1 | 온프렘 방화벽에 등록할 우리 측 IP는 하나 | 접속자가 몇 명으로 늘어도 IP는 1개 유지 |
| 2 | 온프렘 서버에 아무것도 설치하지 않음 | VPN 에이전트 설치 불가. 순수 서버 유지 |
| 3 | 서버가 추가돼도 재설정 없음 | 클라이언트도 방화벽도 손대지 않고 접근 |
| 4 | 인터넷 구간 암호화, 내부망 직접 노출 없음 | |
| 5 | 온프렘에 기존 VPN이 이미 있을 수 있음 | 공존 또는 접속 필요 |
1번이 전부를 결정하게 됐습니다. 접속자가 다섯 명이면 소스 IP도 다섯 개가 됩니다. 그걸 하나로 만들라는 요구는 터널을 뚫어라가 아니라, N개의 출발지를 1개로 압축하는 지점을 어딘가에 만들어라는 뜻이었습니다.
그 지점의 이름이 이제 SNAT이라는 건데요. 이 프로젝트에서 검토한 모든 방식, 자체 WireGuard 허브라든지 Tailscale Subnet Router, Cloudflare의 cloudflared 커넥터, IPsec site-to-site까지 다 같은 그림이었습니다.
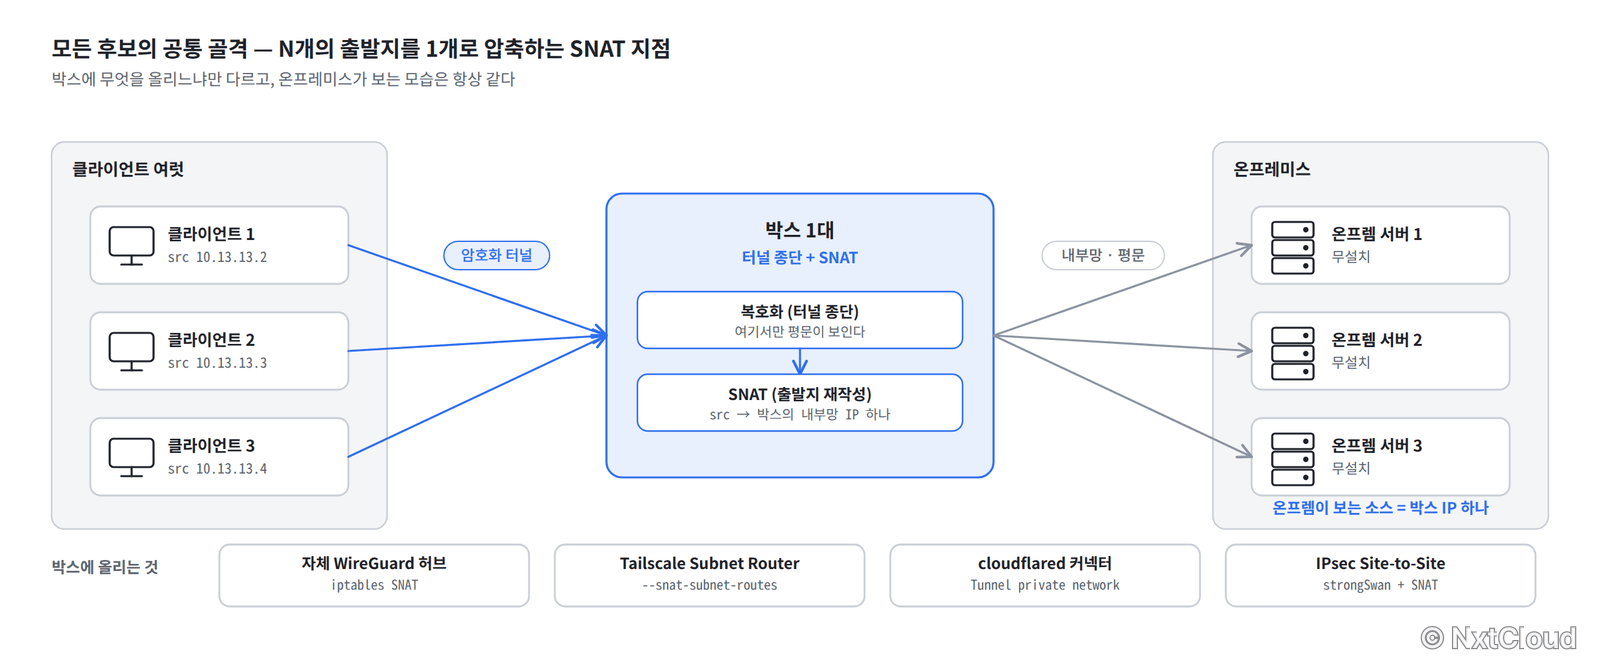 모든 후보의 공통 골격. 클라이언트 여럿이 암호화 터널로 박스 한 대에 모이고, 박스가 복호화와 SNAT을 거쳐 온프레미스 서버로 전달한다. 박스에 올리는 것만 WireGuard 허브, Tailscale Subnet Router, cloudflared 커넥터, IPsec으로 바뀐다
모든 후보의 공통 골격. 박스에 무엇을 올리느냐만 다르고 온프레미스가 보는 모습은 같다
박스에 무엇을 올리느냐만 다르고 골격은 같은 형태입니다. 이 부분을 초반에 잡아둔 덕분에, 나중에 도구를 바꿀 때 온프렘 쪽 협의를 다시 하지 않아도 됐습니다.
후보가 떨어져 나간 순서
조건에 대입을 해보니까 후보가 빠르게 정리가 됐습니다.
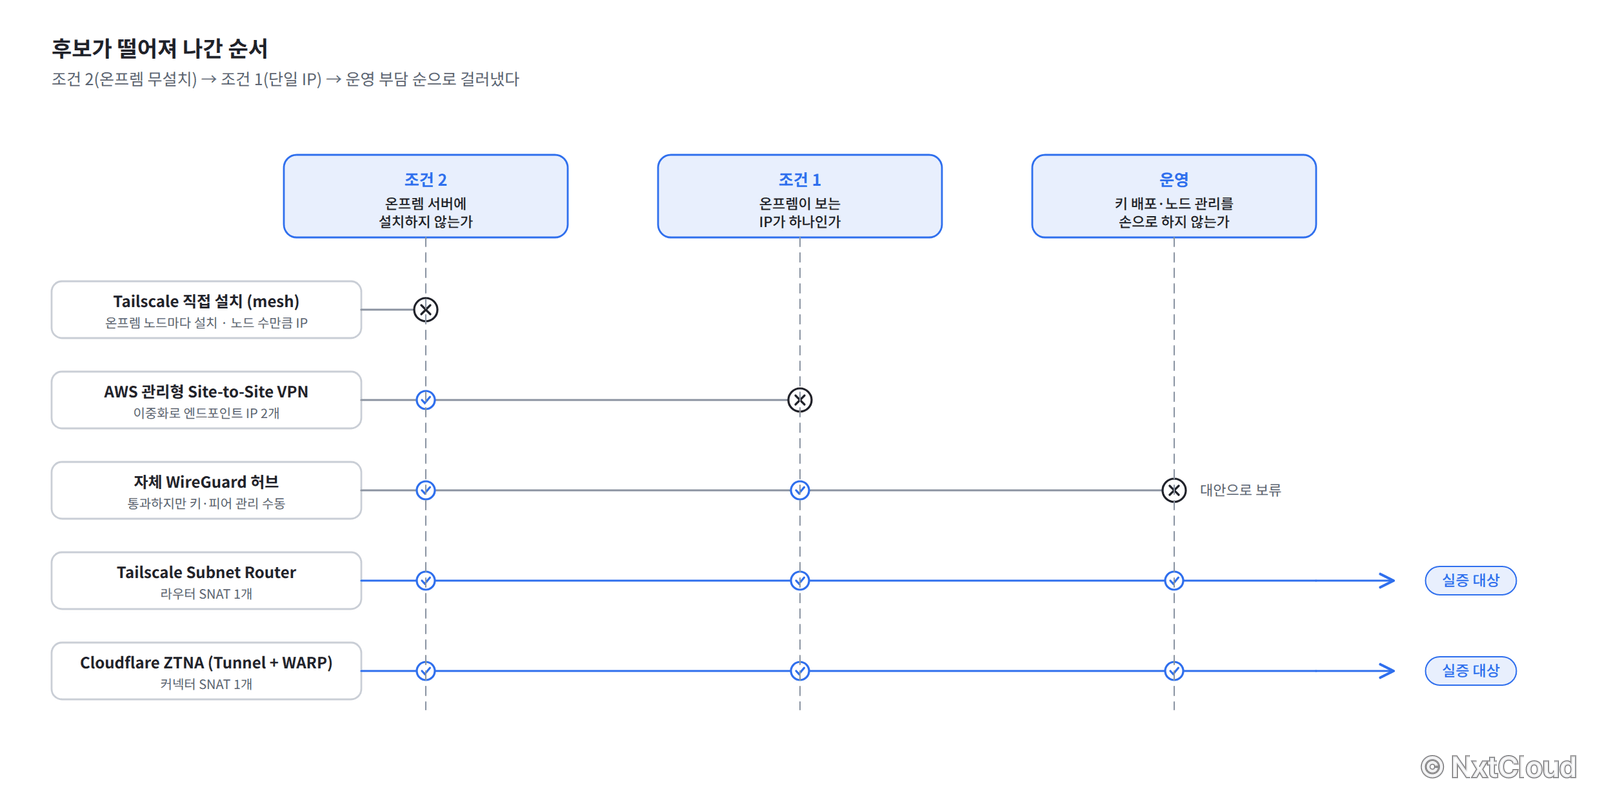 후보가 걸러진 순서. 조건 2(온프렘 무설치), 조건 1(단일 IP), 운영 부담의 세 관문을 차례로 통과시켜 Tailscale Subnet Router와 Cloudflare ZTNA 두 개가 실증 대상으로 남는다
세 관문을 순서대로 통과시킨 결과. 자체 WireGuard 허브는 통과하지만 운영 부담으로 대안에 머문다
AWS 관리형 Site-to-Site VPN이 조건 1에 걸린 게 좀 의외였습니다. 관리형 VPN은 가용성 때문에 터널을 두 개 만들고 엔드포인트도 두 개가 되거든요. IP 딱 하나라는 문구 앞에서는 그 이중화가 오히려 탈락 사유가 되어버립니다.
Tailscale을 온프렘 서버에 직접 까는 mesh 형태도 초기에 검토를 했다가 접게 되었습니다. 노드마다 tailnet IP를 받다 보니까, 접속자가 늘면 온프렘이 관측하는 IP도 같이 늘어납니다. 조건 1하고 정면으로 부딪히는 부분입니다.
남은 셋 중에 자체 WireGuard 허브는 키 배포라든지 노드 관리를 전부 손으로 해야 되다 보니까 대안으로 좀 내려두고, Tailscale Subnet Router하고 Cloudflare ZTNA[1] 두 개를 실증 대상으로 잡게 되었습니다.
VPN이라는 말에는 두 계보가 섞여 있습니다
본격적으로 들어가기 전에 이제 용어를 좀 정리를 해두는 게 좋을 것 같습니다. VPN을 한 덩어리로 부르는데, 실제로는 동작 계층이 다른 두 계보가 섞여 있습니다.
IPsec 계열은 L3에서 IP 패킷 자체를 암호화합니다. OS 네트워크 스택 안쪽에서 처리가 되다 보니까 애플리케이션은 VPN의 존재를 알 필요조차 없습니다. IKE로 키를 교환하고 ESP로 패킷을 감쌉니다. 라우터나 이런 방화벽 장비에서 오래 표준으로 쓰였고, AWS Site-to-Site VPN하고 GCP Cloud VPN이 이 계열입니다. 대신 협상을 할 파라미터가 많다 보니까 설정이 좀 까다롭고 NAT 통과도 번거롭긴 합니다.
SSL/TLS 계열은 L4에서 L7 사이에서 동작을 합니다. 브라우저 HTTPS하고 같은 자리입니다. 443 포트를 그대로 쓰니까 방화벽 정책을 우회하기가 쉽고, 클라이언트 배포라든지 사용자 인증이 유연합니다. OpenVPN이나 이런 Cisco AnyConnect가 여기 속합니다. 흔히 SSL VPN이라고 부르는 게 이 계열이고, 용도는 대체로 사람이 노트북으로 접속하는 원격 접속입니다.
이 구분이 실무에서 왜 중요하냐면, 저희가 필요했던 게 사람의 원격 접속이 아니라 머신 대 머신 상시 연결이었거든요. 서버가 서버에 붙는 L3 site-to-site라는 형태입니다. 이 성격이 정해지는 순간 SSL VPN 계열은 자연스럽게 후보에서 빠지게 됩니다. 방화벽 우회 능력이라든지 브라우저 접근성은 이 문제에서 값을 못 합니다.
그리고 세 번째 구현체가 있습니다.
| 항목 | IPsec | OpenVPN | WireGuard |
|---|---|---|---|
| 계층 | L3 | L4/L7 | L3 |
| 코드 규모 | 수십만 줄 | 큼 | 약 4천 줄 |
| 실행 위치 | 커널 | 사용자 공간 | 커널 |
| 설정 난이도 | 어려움 | 보통 | 쉬움 |
| 사용자 인증 | 유연 | 유연 | 없음. 외부에 위임 |
| 대표 용도 | Site-to-Site | Remote Access | 둘 다 |
WireGuard의 약 4천 줄이라는 건 마케팅 문구가 아니라 설계 철학인데요. 이게 왜 그런 결과를 낳는지는 직접 뜯어보는 편이 빠릅니다.
WireGuard를 뜯어봤습니다
Docker로 허브 앤 스포크[2] 랩을 만들어가지고 계측을 했습니다. 클라이언트 두 대, 허브 한 대, 그리고 WireGuard가 설치되지 않은 순수 온프렘 서버 한 대인 구성입니다.
신원은 공개키 하나입니다
wg show가 인증 원장 그 자체입니다. X.509라든지 CA, CRL 이런 게 하나도 없습니다.[3]
peer: OBVIYQ8ZzxfFcJGSp3IcsW1RbGi2Fp34/kSY55XEU0s=
  endpoint: 10.100.0.20:59032
  allowed ips: 10.13.13.2/32
  latest handshake: 2 minutes, 2 seconds ago
  transfer: 25.92 KiB received, 11.61 KiB sent
허브가 아는 공개키하고 클라이언트가 실제로 가진 키가 일치하면 그게 신원이 됩니다. 인증 스택은 Noise IK라는 핸드셰이크 하나로 고정이 되어 있습니다.[4] Curve25519로 키를 교환하고 BLAKE2s로 키를 파생하며 ChaCha20-Poly1305로 암호화를 합니다. 협상이라는 게 아예 없습니다. IPsec에서 IKE 버전, DH group, 암호 스위트, PFS, SA lifetime을 상대와 맞추느라 쓰는 시간이 여기서는 통째로 사라집니다.[5] 대신 알고리즘을 고를 자유도 없긴 합니다. 이 교환이 이제 4천 줄의 정체입니다.
좀 주목할 부분은 endpoint가 인증에 관여를 하지 않는다는 점이었습니다. 클라이언트가 카페 와이파이로 옮겨서 소스 IP가 바뀌어도, 공개키만 맞으면 세션이 그대로 이어집니다. 로밍이 공짜로 딸려오는 형태입니다.
AllowedIPs는 라우팅 테이블이면서 방화벽입니다
WireGuard 설정에서 제일 오해하기 쉬운 부분입니다. AllowedIPs는 두 가지 일을 동시에 하게 됩니다.
나갈 때는 라우팅 테이블입니다. 목적지가 어느 피어의 AllowedIPs에 속하는지 보고 그 피어로 보냅니다. 들어올 때는 암호학적인 필터가 됩니다. 피어 A의 키로 복호화된 패킷의 출발지가 A의 AllowedIPs 밖이면 조용히 버립니다.
그래서 허브 설정에서 클라이언트별 AllowedIPs를 넓게 잡아버리면, 한 클라이언트가 다른 클라이언트의 IP를 사칭한 패킷을 보낼 수가 있게 됩니다. 반드시 /32로 좁혀야 되는 부분입니다. 이 한 줄이 이제 스푸핑 방어선이 됩니다.
암호화 경계를 눈으로 봤습니다
제일 확실했던 건 이제 한 번의 curl이 허브의 세 인터페이스에서 각각 어떻게 보이는지를 동시에 캡처를 해보는 형태였습니다.
docker compose exec -d wg-hub bash -c '
  (timeout 5 tcpdump -i eth0 -nn -l udp port 51820 > /tmp/cap-eth0.txt) &
  (timeout 5 tcpdump -i wg0  -nn -l                > /tmp/cap-wg0.txt)  &
  (timeout 5 tcpdump -i eth2 -nn -l                > /tmp/cap-eth2.txt) &
  wait'
docker compose exec client-a curl -s http://10.60.0.100/
결과가 이렇게 나왔는데요.
| 인터페이스 | 보이는 것 | src → dst |
|---|---|---|
| eth0 (외부) | UDP 51820 암호문만. HTTP 흔적 없음 | 10.100.0.20:59032 → 10.100.0.10:51820 |
| wg0 (터널 내부) | GET / HTTP/1.1 평문 육안 확인 | 10.13.13.2:42798 → 10.60.0.100:80 |
| eth2 (SNAT 후) | 같은 평문, src만 바뀜 | 10.60.0.10:42798 → 10.60.0.100:80 |
표 한 장에 두 개념이 다 들어가 있습니다. eth0하고 wg0 사이가 암호화 경계고, wg0하고 eth2 사이가 SNAT이 일어나는 부분입니다. 커널 파이프라인으로 써보면 이렇게 흐르게 됩니다.
eth0(UDP 캡슐화) → WG 커널 모듈 복호화 → wg0(평문) → iptables SNAT → eth2(평문, src 재작성)
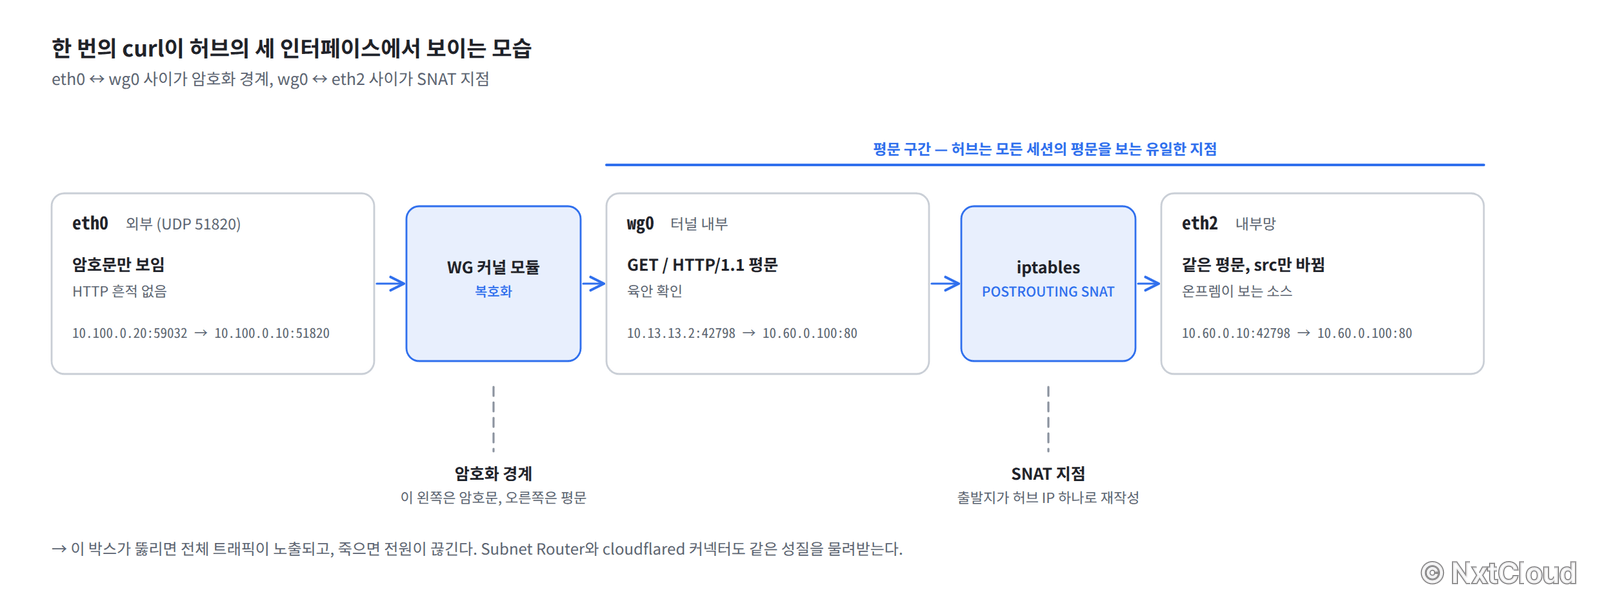 한 번의 curl이 허브의 세 인터페이스에서 보이는 모습. eth0에서는 암호문만, WG 커널 모듈을 지나 wg0에서는 평문이, iptables SNAT을 지나 eth2에서는 출발지가 허브 IP로 바뀐 평문이 보인다
eth0과 wg0 사이가 암호화 경계, wg0과 eth2 사이가 SNAT 지점. 허브는 모든 세션의 평문을 보는 유일한 자리다
여기서 보안적으로 좀 중요한 부분이 하나 따라 나오는데요. 허브가 모든 세션의 평문을 보는 유일한 지점이 되는 형태거든요. 이 박스가 뚫리면 전체 트래픽이 노출이 되고, 이 박스가 죽으면 전원이 다 끊기게 됩니다. 뒤에 나올 Tailscale의 subnet router라든지 Cloudflare의 커넥터도 정확하게 같은 성질을 물려받습니다. 그러다 보니까 어떤 도구를 쓰든 이 박스를 강화하고 이중화하는 게 최우선이 됩니다.
클라이언트를 늘려도 IP는 하나입니다
조건 1의 검증은 간단했습니다. 서로 다른 클라이언트 두 대에서 온프렘 서버로 요청을 보내고, 서버가 관측한 소스 IP를 확인을 해봤습니다.
| 요청 | 온프렘이 본 소스 |
|---|---|
| client-a | 10.60.0.10 |
| client-b | 10.60.0.10 |
다른 피어인데 같은 IP가 찍힙니다. 허브의 iptables -t nat -L POSTROUTING -n -v 카운터하고 온프렘의 INPUT 카운터가 정확하게 맞아떨어지는 것까지 확인을 했습니다. 온프렘 화이트리스트에 넣을 IP는 허브 하나면 되는 형태입니다.
참고로 커널 WireGuard의 처리량은 랩 환경에서 iperf3 기준 1324 Mbps가 나왔습니다. 사용자 공간에서 도는 구현체하고 비교를 하면 커널 모듈의 이점이 여기서 드러납니다. 다만 뒤에 나오는 Tailscale은 사용자 공간 구현인 wireguard-go를 쓰다 보니까, 이 숫자를 Tailscale의 성능으로 읽으시면 안 됩니다.[6]
경로가 성능을 정합니다
랩에서는 모든 경로가 도커 브리지 위다 보니까 성능 차이가 안 났습니다. 실제로는 공용 인터넷을 타는 경로하고 전용선을 타는 경로가 완전히 다른 물건인데, 그게 재현이 안 되다 보니 tc netem으로 인터넷 조건을 인위적으로 주입을 했습니다.[7]
# A 경로: 공용 인터넷 시뮬 - 지연 80ms 편차 20ms, 손실 0.5%, 대역 100Mbps
tc qdisc add dev eth1 root handle 1: netem delay 80ms 20ms distribution normal loss 0.5%
tc qdisc add dev eth1 parent 1:1 handle 10: tbf rate 100mbit burst 32kbit latency 400ms

# B 경로: 전용선 시뮬 - 백본 지연만
tc qdisc add dev eth2 root netem delay 5ms
네 가지 지표를 재봤는데요.
| 지표 | A (인터넷) | B (전용선) | 배수 |
|---|---|---|---|
| RTT 평균 | 91.2 ms | 6.9 ms | 13배 |
| 지터 (mdev)[8] | 14.6 ms | 0.5 ms | 29배 |
| TCP 처리량 | 5.24 Mbps (재전송 207회) | 1286 Mbps (재전송 0) | 245배 |
| UDP 손실률 (500Mbps 목표) | 84% | 0.47% | |
| curl 총 소요 | 161-200 ms | 12.7-14.2 ms | 13배 |
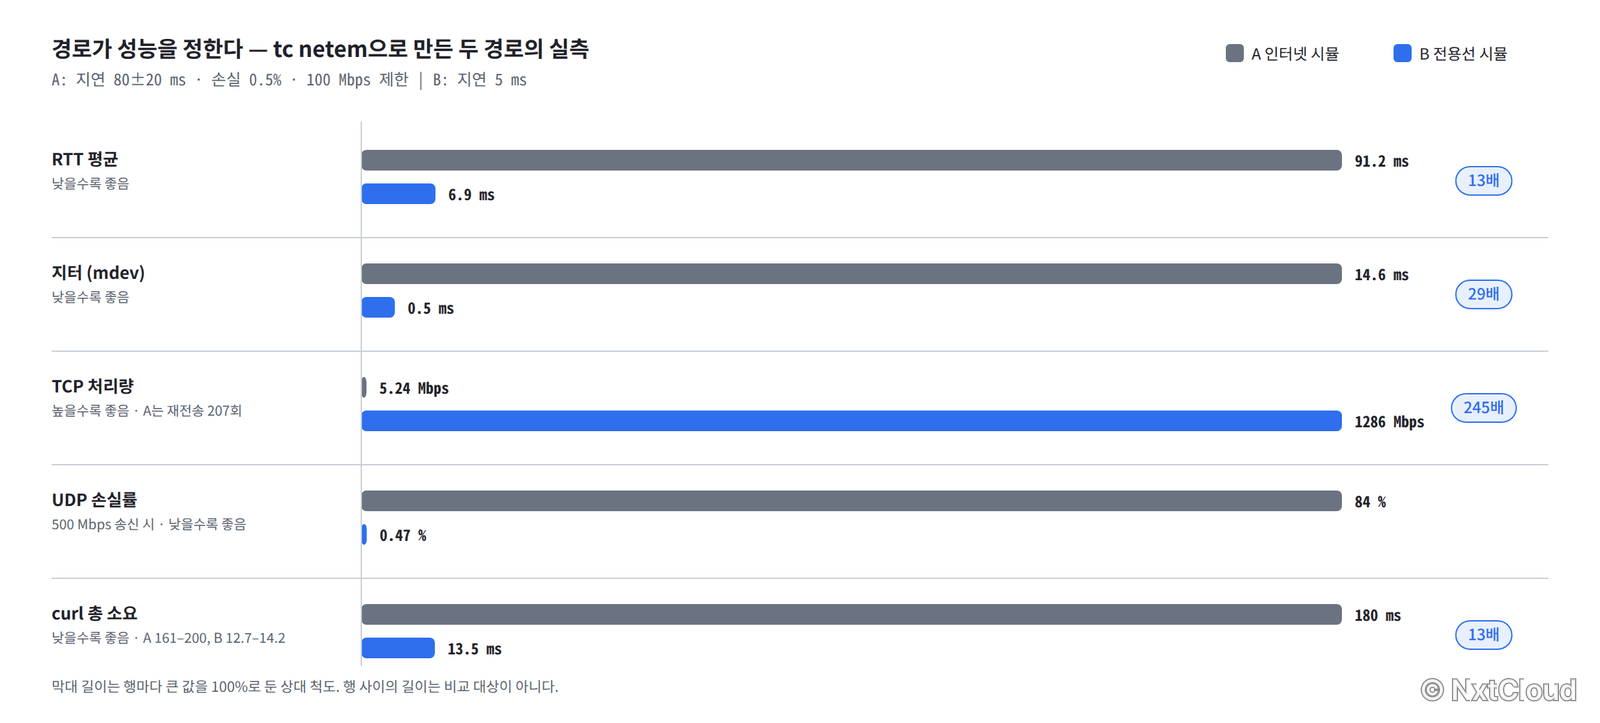 두 경로의 실측 비교 차트. RTT, 지터, TCP 처리량, UDP 손실률, curl 소요 시간 다섯 지표에서 인터넷 시뮬 경로 A와 전용선 시뮬 경로 B를 막대로 나란히 놓았다
막대 길이는 행마다 큰 값을 100%로 둔 상대 척도. 행 사이의 길이는 비교 대상이 아니다
TCP 항목이 좀 눈에 띕니다. A 경로는 100Mbps 대역을 목표로 걸었는데 실제로는 5Mbps밖에 못 냈습니다. 지연이랑 손실이 겹치다 보니까 TCP 혼잡 제어가 계속 윈도를 줄이는, long fat network라는 문제입니다.[9] 회선 계약서에 적힌 대역폭하고 실제 처리량은 별개라는 걸 숫자로 확인을 한 셈입니다.
UDP는 좀 더 극단적입니다. 100Mbps 상한에 500Mbps를 밀어넣었으니 8할은 정의상 버려지는 게 맞는데요. 중요한 건 TCP처럼 알아서 속도를 줄이는 장치가 없다 보니 그 손실이 그대로 애플리케이션에 노출이 된다는 부분입니다. 실시간 프로토콜을 이런 경로에 올리면 안 된다는 결론이 바로 나오게 됩니다.
여기서 배우게 된 건 검증 방법론 쪽이 더 큽니다. ping만 보고 연결됐다고 판정을 하면 절반만 본 셈입니다. 지연이라든지 지터, 처리량, 손실은 각각 다른 이야기를 하고, 넷을 다 봐야 경로의 성격이 완성이 됩니다. 그리고 RTT가 높다고 해서 통신 실패는 아닙니다. 판정 기준은 손실률입니다.
1차 답 - Tailscale Subnet Router
WireGuard의 원리는 확인을 했는데, 그대로 쓰기에는 좀 걸리는 부분이 있었습니다. 키 배포라든지 피어 관리가 전부 수동이고, NAT 뒤에 있는 노드들을 직접 연결하기가 어렵습니다. Tailscale은 이제 이 둘을 SaaS로 푼 물건입니다.
구조는 명확한 편입니다. 컨트롤 플레인은 Tailscale이 SaaS로 돌리면서 노드 목록, 공개키 교환, ACL 배포, NAT 관통 중개만 합니다. 데이터 플레인은 노드끼리 직접 WireGuard로 붙는 형태입니다. 사설키가 기기 밖으로 나가지 않다 보니까 Tailscale조차 내용을 못 봅니다. 직접 연결에 실패하면 DERP 릴레이가 암호화된 덩어리만 중계를 하게 됩니다.[10]
저희한테 중요했던 기능은 subnet router라는 기능이었습니다. 라우터 한 대만 tailnet에 넣고 온프렘 대역을 광고하면, 그 대역 안의 서버들은 아무것도 설치하지 않은 채로 접근 대상이 됩니다.
tailscale up --advertise-routes=10.99.0.0/24
여기서 처음에 좀 헷갈렸던 부분이 있습니다. 두 개의 IP 대역이 등장하는데 이걸 섞으면 안 됩니다. tailnet 노드가 받는 IP는 100.64.0.0/10 CGNAT 대역으로 고정이고 바꿀 수가 없습니다.[11] 광고하는 온프렘 대역은 제가 고르는 값입니다. Tailscale이 관리하는 대역 안에서 특정 IP만 뚫는다는 식으로 이해를 했다가 바로잡게 되었습니다.[12]
--snat-subnet-routes가 기본으로 켜져 있다 보니까, 온프렘 서버가 보는 소스는 항상 라우터의 온프렘 쪽 IP 하나가 됩니다. 조건 1이 여기서 성립을 합니다. 그리고 클라이언트는 개별 서버 IP가 아니라 대역 통째를 라우팅 테이블에 받게 되어서, 온프렘에 서버가 100대로 늘어도 클라이언트는 영원히 설정을 안 바꿔도 됩니다. 조건 3이 여기서 성립을 하게 됩니다.
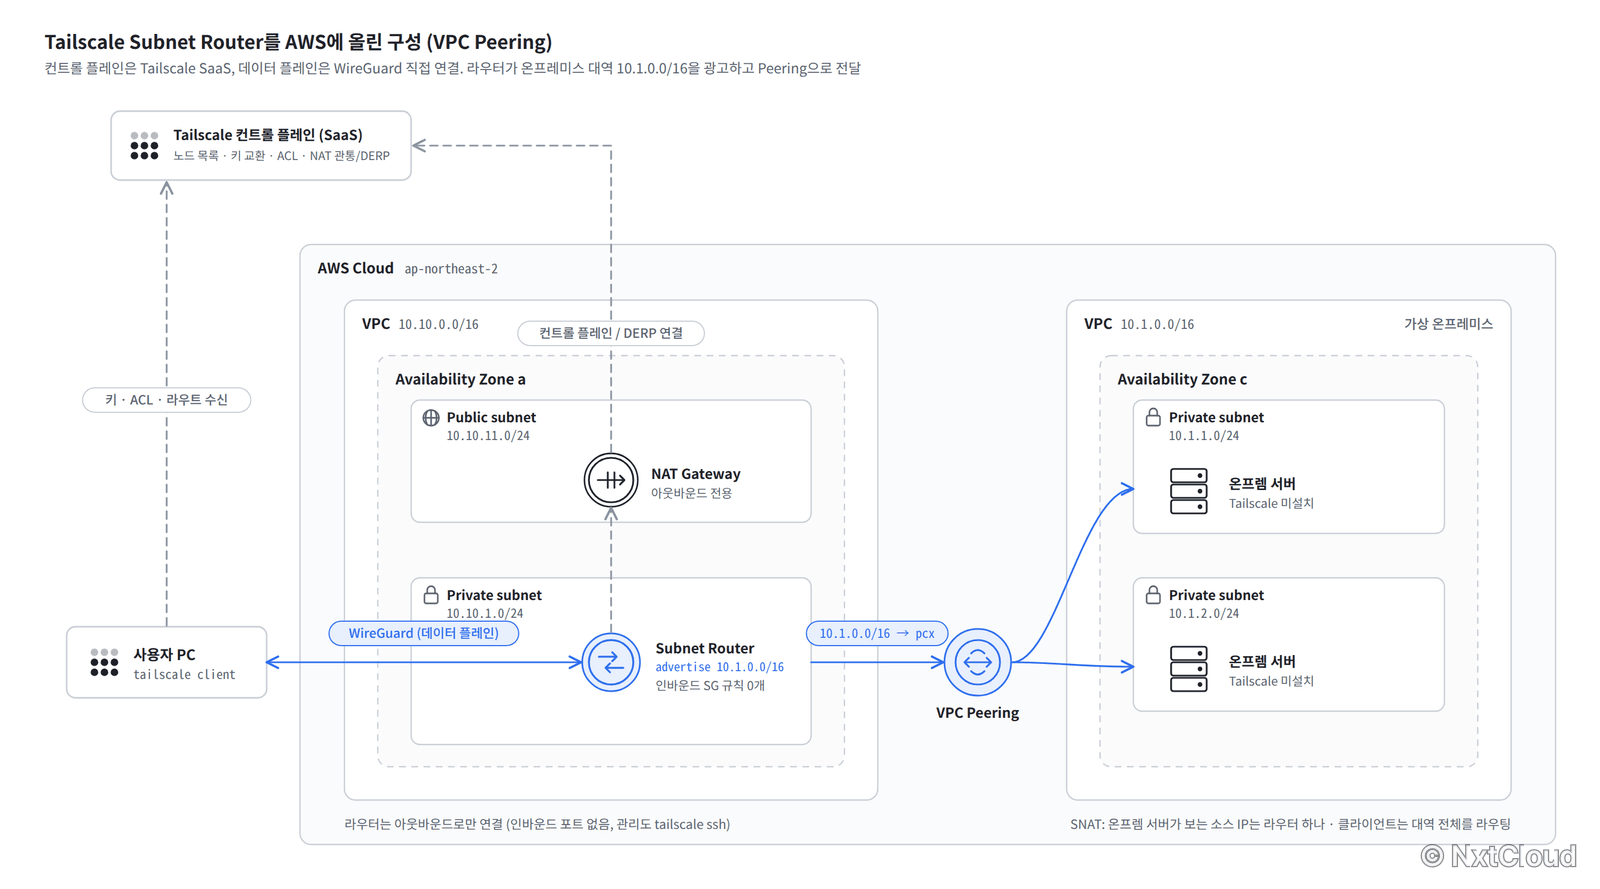 Tailscale Subnet Router를 AWS에 올린 구성. 컨트롤 플레인은 Tailscale SaaS, 데이터 플레인은 WireGuard 직접 연결이며 라우터가 온프레미스 대역 10.1.0.0/16을 광고하고 VPC Peering으로 전달한다
AWS로 올릴 때는 VPC 두 개를 Peering으로 붙여가지고 라우터를 private subnet에 뒀습니다. 좀 인상적이었던 건 라우터의 인바운드 보안그룹 규칙이 0개인 채로 전부 동작을 하더라는 점이었습니다. Tailscale은 아웃바운드로만 연결을 맺고, 관리용 SSH조차 22번 포트 대신 tailscale ssh로 처리가 됩니다. 열어둔 포트가 없다 보니까 스캔 대상도 아니게 됩니다.
한 가지 더 알게 된 건 격리가 인증 키로 되는 게 아니라는 부분입니다. 고객사별로 나누려고 실험을 하다가 알았는데요. auth key가 같다는 건 같은 tailnet에 들어간다는 뜻일 뿐입니다. 기본 ACL이 전원 허용이다 보니까 클라이언트 하나가 모든 고객사 대역에 다 닿았습니다. 격리는 태그 기반 ACL로 해야 되고, 그 정책 파일은 git으로 관리를 하는 게 맞습니다.
이 시점에 저희 프로덕션 EKS에는 이미 Tailscale이 파드 형태로 올라가 있었습니다. 파드가 egress 게이트웨이를 거쳐서 단일 IP로 나가는 구조입니다.
2차 - 같은 요구를 Cloudflare ZTNA로 재현했습니다
Tailscale로 요구조건을 다 충족했는데도 Cloudflare Zero Trust를 따로 검증을 한 이유는, 접근 제어라든지 감사 요구가 계약 단계에서 올라올 조짐이 보였거든요. 그래서 같은 요구조건을 ZTNA로도 만족할 수 있는지 AWS에서 직접 재현을 해봤습니다.
대응 관계가 거의 일대일이었습니다.
| Tailscale | Cloudflare | 역할 |
|---|---|---|
| Subnet Router | cloudflared 커넥터 | 온프렘망 게이트웨이, SNAT 지점 |
--advertise-routes | Tunnel Private Network Route | 광고할 대역 등록 |
| Tailscale 클라이언트 | WARP + Split Tunnel Include[13] | 단말에서 대상 대역만 터널로 |
| Tailscale ACL | Gateway Network Policy | 사용자와 리소스 단위 인가 |
tailscale ssh | Access for Infrastructure | SSH 세션 감사 |
핵심 대응은 subnet router가 곧 cloudflared 커넥터라는 부분입니다. 둘 다 온프렘 서버 무설치이고, 온프렘망에 박스 한 대를 두고, SNAT로 IP를 하나로 압축하는 형태입니다.
검증도 같은 항목으로 돌렸습니다. 온프렘 서버에서 tcpdump -i any icmp -n을 걸고 WARP를 켠 PC에서 접근을 해봤더니, 소스가 커넥터의 사설 IP 하나로만 찍혔습니다. WARP 클라이언트 IP가 아닙니다. 조건 1 성립입니다.
커넥터도 아웃바운드로만 터널을 엽니다. compose 파일에 published 포트가 아예 없습니다. 온프렘 방화벽 인바운드 규칙이 0개인 채로 접근이 성립하는 건 Tailscale하고 같은 부분입니다.
다른 건 인가 쪽이었습니다. Gateway Network Policy로 목적지 IP라든지 포트, 사용자 신원을 조합해가지고 정책을 쓸 수가 있습니다. 실제로 Destination IP is 10.1.1.9 → Block 정책을 걸어서 특정 서버만 차단이 되는 걸 확인했습니다. Tailscale ACL이 대역하고 포트 단위인 데 비해서 한 단계 더 내려갑니다.
왜 갈아탔나
두 방식 모두 요구조건 1번부터 4번까지를 실증으로 충족을 했습니다. 그래서 선택은 무엇이 부족한가가 아니라 무엇을 우선하는가의 문제였는데요. 최종적으로는 Cloudflare ZTNA를 고르게 되었습니다.
우선은 인원 한도 부분입니다. Cloudflare Zero Trust는 50유저까지 무료거든요. Tailscale의 무료 티어는 한 자릿수 인원이다 보니까, PoC를 넘어서 실사용 인원을 받으면 바로 유료 구간으로 들어가게 됩니다.[14] 초기 도입 비용이 0이라는 게 생각보다 좀 크게 작용을 했습니다.
그 다음에 운영이라든지 콘솔 일원화 부분인데요. 터널, 정책, 로그 이런 것들이 한 대시보드에 모이는 형태입니다. 커넥터를 replica로 늘려가지고 이중화를 하는 것도, 라우터를 두 대 세우고 온프렘 화이트리스트에 IP를 둘 다 등록하는 것보다 손이 좀 덜 갑니다. 고객사가 여러 곳으로 늘어나는 상황을 가정하면 이 차이가 누적이 됩니다.
그리고 사용자별 인가나 이런 감사 부분입니다. 앞에서 본 Gateway Network Policy에 더해서 Gateway Logs라든지 Access for Infrastructure의 세션 기록이 있습니다. 누가 언제 어디에 접근을 했는가를 남기라는 요구가 들어왔을 때 바로 답이 되는 그런 기능입니다.
그리고 예상이 뒤집힌 지점
비교표를 처음 그렸을 때 저희는 Tailscale 쪽에 저지연이라고 적어뒀거든요. P2P 직결이다 보니까 엣지를 한 번 거치는 Cloudflare보다 당연히 빠를 거라고 봤습니다.
근데 실제로는 아니었습니다. NAT 환경에서 P2P 관통이 실패해서 DERP 릴레이로 폴백이 되는 상황을 겪었는데요. 그렇게 되면 트래픽은 결국 Tailscale의 릴레이 서버를 한 번 거치게 됩니다. 원인은 라우터가 AWS NAT Gateway 뒤에 있었다는 부분이었습니다. 홀펀칭은 STUN으로 알아낸 공인 IP하고 포트를 서로에게 알려주고, 양쪽이 동시에 그 주소로 두드려서 구멍을 내는 방식인데요. NAT Gateway는 목적지가 달라지면 공인 포트를 새로 배정을 합니다. 대칭형 NAT하고 사실상 같은 동작입니다. STUN 서버와 얘기할 때 40001을 썼어도 피어로 나갈 때는 40002가 배정이 되니까, 상대가 40001로 두드려봐야 거긴 열린 구멍이 없습니다. tailscale status에 relay "tok"으로 찍혀서 도쿄 DERP를 타고 있다는 걸 확인하게 되었습니다. 즉 P2P라서 빠르다는 전제 자체가 성립을 안 하는 환경이 있었습니다. 반면에 Cloudflare는 엣지 경유가 기본 설계다 보니까 경로가 처음부터 예측이 가능하고, 실측 체감으로는 응답이 오히려 더 안정적이긴 했습니다. 아쉽게도 이 구간의 수치를 따로 기록해두지 않아서 여기서는 정성적인 서술에 그치게 됐습니다.
 NAT 홀펀칭이 성공하는 정상 케이스와, 라우터가 AWS NAT Gateway 뒤에 있어 실패하고 도쿄 DERP 릴레이로 폴백한 우리 케이스를 위아래로 비교한 도식. STUN에 알려준 포트와 피어로 나갈 때 새로 배정되는 포트가 달라 구멍이 열리지 않는 지점을 표시했다
스펙표의 화살표하고 실측 결과가 반대로 나온 경험이었습니다. 아키텍처 문서에 P2P 저지연이라고 적을 때, 그 앞에 NAT 관통에 성공하면이라는 조건이 생략이 되어 있다는 걸 그때 알게 되었습니다.
대신 내준 것
정직하게 적자면 Cloudflare를 고르면서 포기하게 된 부분도 분명히 있습니다.
Tailscale은 종단간 암호화입니다. 사설키가 기기 밖으로 안 나가다 보니까 Tailscale도 내용을 못 봅니다. Cloudflare는 엣지에서 TLS를 종료하고 다시 암호화를 합니다. 즉 제 트래픽을 볼 수 있는 위치에 있는 형태입니다.
네트워크 안에 들어왔다고 해서 아무도 믿지 않는다는 게 Zero Trust인데요. 그 구현을 위해서 특정 벤더는 전적으로 믿어야 하는 구조가 되어버립니다. 데이터 플레인까지 SaaS에 의존을 하게 되다 보니까, SaaS 사용이 금지되는 컴플라이언스 환경이라면 이 방식은 애초에 후보가 아닙니다. 그런 경우에는 자체 WireGuard 허브나 이런 IPsec site-to-site로 돌아가야 됩니다.
덧붙이면 Zero Trust라는 건 제품 이름이 아니라 보안 모델입니다. Tailscale도 기기별 키라든지 SSO 신원, ACL을 갖춘 엄연한 ZTNA입니다. 둘의 차이는 Zero Trust냐 아니냐가 아니라 mesh냐 proxy냐, 그리고 벤더를 어디까지 믿느냐인 부분입니다.
 Tailscale 의 mesh 구성과 Cloudflare ZTNA 의 proxy 구성에서 평문을 볼 수 있는 위치를 나란히 표시한 도식. Tailscale 은 우리 박스 한 곳, Cloudflare 는 벤더 엣지가 하나 더 생긴다
박스 뒤는 평문인데 괜찮은가
여기까지 읽으시면 두 가지가 좀 걸리실 겁니다. 하나는 박스가 복호화한 뒤부터 온프렘 서버까지는 암호화가 없다는 부분이고, 다른 하나는 방화벽이 IP 하나만 보고 통과를 시키는데 그 IP를 위조하면 어떻게 되느냐는 부분입니다. PoC 중에 저도 같은 질문을 받았거든요.
첫 번째는 사실입니다. 앞의 tcpdump 표에서 wg0하고 eth2 구간이 그 자리고, Tailscale의 subnet router도 Cloudflare의 커넥터도 똑같습니다. 서버에 아무것도 설치하지 않기로 한 순간, 서버가 직접 복호화하는 종단이 될 수가 없다 보니까 구조적으로 따라오는 비용입니다. 그래서 이게 취약점인지는 그 평문 구간이 어디를 지나가느냐로 갈리게 됩니다. 박스가 온프렘 DMZ 안에 있으면 평문은 고객사 내부망 안에서만 흐르고, 사내 서버끼리 오가는 트래픽하고 같은 신뢰 수준이라 대부분 수용이 됩니다. 반대로 박스가 AWS에 있고 온프렘이 인터넷 건너편이면, NAT 게이트웨이하고 온프렘 게이트웨이 사이에 IPsec이든 WireGuard든 site-to-site 터널이 반드시 있어야 됩니다. 방화벽의 IP 허용은 접근 제어일 뿐이지 기밀성을 주지는 않거든요. 그리고 터널하고 별개로, 서비스 자체의 암호화를 켜는 방법이 있습니다. SSH는 원래 암호화가 되어 있고, 웹은 HTTPS, DB는 PostgreSQL의 sslmode=verify-full이나 MySQL의 require_secure_transport, RDP는 TLS/NLA처럼 서버가 이미 갖고 있는 기능이다 보니까 설치가 아닙니다. 이렇게 하면 박스는 암호문을 암호문으로 넘기는 라우터가 되고, 박스가 뚫리면 전체 평문이 노출된다는 위험까지 같이 줄어들게 됩니다.
두 번째로, IP 위조는 인터넷 건너편에서는 현실적으로 안 됩니다. 출발지를 위조한 SYN을 보내면 SYN+ACK는 진짜 주인에게 날아가다 보니까 공격자는 받지를 못합니다. 핸드셰이크를 끝내려면 서버가 고른 초기 시퀀스 번호를 알아야 되는데요. 지금은 모든 OS가 이 값을 무작위화해서[15] 32비트를 찍어 맞춰야 됩니다. 1990년대에는 이 번호가 예측이 가능해서 실제로 성공한 사례가 있었지만[16] 지금은 아닙니다. 다만 이 논리는 두 전제 위에 서 있습니다. 응답이 공격자를 거치지 않는다는 것, 그리고 TCP처럼 왕복이 필요하다는 것. 같은 L2에서 ARP를 속인다든지 BGP 하이재킹으로 경로를 끌어오는 경로상 공격자는 첫 전제를 깨고,[17] syslog나 이런 SNMP처럼 UDP 패킷 한 방으로 동작하는 서비스는 두 번째 전제를 깹니다. 그리고 위조와 무관하게 더 자주 터지는 문제가 있는데요. 방화벽은 "그 IP에서 왔다"만 볼 수 있고 "그 IP 뒤의 누가 보냈다"는 못 봅니다. NAT IP 하나를 허용하면 그 뒤의 EKS 파드 전부가 정당한 허용 대상이 되어버리는 형태입니다. 앞에서 격리는 인증 키가 아니라 ACL로 해야 된다고 쓴 교훈이 정확하게 이 지점하고 맞닿아 있습니다.
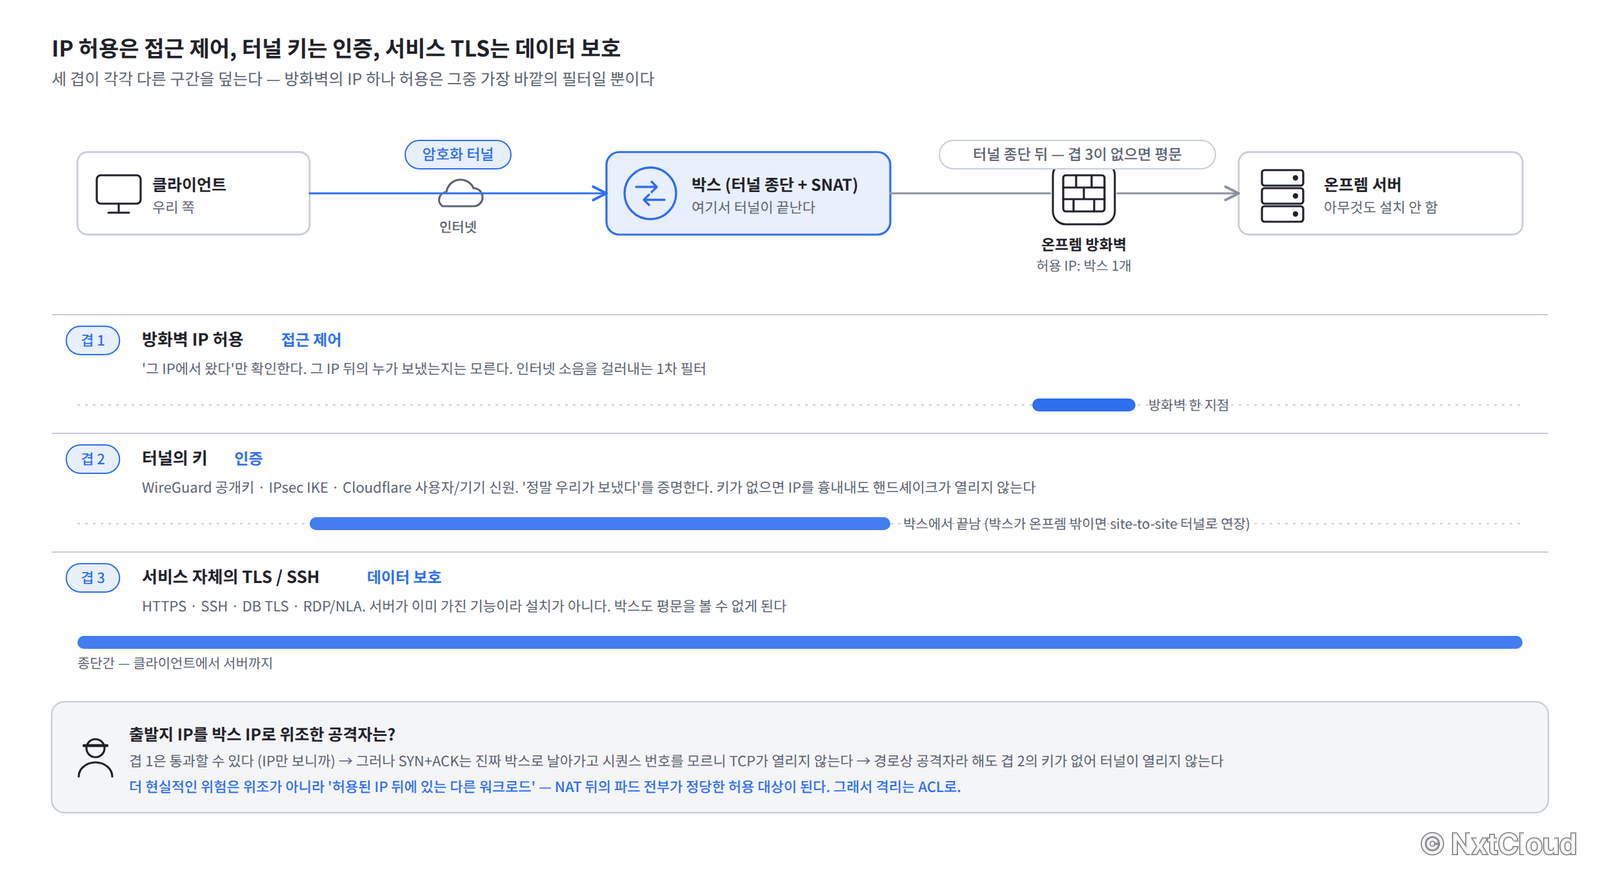 방화벽 IP 허용(접근 제어), 터널의 키(인증), 서비스 자체의 TLS(데이터 보호) 세 겹이 각각 어느 구간을 덮는지 막대로 나란히 보여준다. 아래에 출발지 IP를 위조한 공격자가 겹 1은 지나도 겹 2의 키에서 막혀 터널이 열리지 않는 흐름을 함께 적었다
정리를 하면 세 겹입니다. 방화벽의 IP 허용은 접근 제어, 터널의 키는 인증, 서비스의 TLS는 데이터 보호가 됩니다. IP 허용은 인터넷의 소음을 걸러내는 1차 필터로는 훌륭한데 인증은 아닙니다. 정말 저희가 보낸 것임을 증명하는 건 WireGuard의 공개키라든지 IPsec의 IKE 인증, Cloudflare의 사용자·기기 신원입니다. 경로상 공격자가 IP를 흉내내는 데 성공을 해도 키가 없으면 핸드셰이크가 안 열립니다. WireGuard는 첫 패킷부터 키로 인증된 핸드셰이크다 보니까, 알 수 없는 상대에게는 응답조차 하지 않도록 설계가 되어 있습니다.[18]
막혔던 지점들
구축을 하면서 실제로 시간을 좀 뺏긴 부분들입니다. 다음에 같은 걸 하실 분한테는 이 목록이 본문보다 쓸모가 있을 수도 있겠네요.
Split Tunnel의 서브넷 마스크. 대상이 10.10.25.11인데 Include에 10.10.0.0/24를 넣고 왜 안 되는지 한참 봤습니다. /24는 10.10.0.x만 덮습니다. VPC 전체를 쓰려면 /16이어야 되고, Include하고 Tunnel Route 양쪽 다 그렇습니다.
디바이스 프로필 중복. 같은 이름의 Onboarding 프로필이 네 개 있었고, 제가 고친 프로필하고 기기에 실제로 매칭된 프로필이 달랐습니다. 설정을 바꿨는데 안 바뀐다의 정체가 이거였습니다. 프로필은 위에서 아래로 우선순위가 매겨지고 Default는 fallback입니다. 단일 사용자라면 Default 하나로 통일을 하는 게 낫습니다.
ICMP는 Gateway Network Policy의 대상이 아닙니다. 이게 제일 위험했습니다. 정책으로 차단을 해놓고 ping이 통하길래 정책이 안 먹는 줄 알았는데, 애초에 ICMP는 정책 평가 대상이 아닙니다.[19] 차단 테스트도 도달 테스트도 nc -vz <ip> <port>처럼 TCP로 해야 됩니다.
VPC Peering 라우트는 양방향. 한쪽 라우팅 테이블에만 상대 대역을 넣으면 요청은 가는데 응답이 못 돌아옵니다.
보안그룹은 프로토콜별로 따로. ICMP 허용하고 TCP 22 허용은 별개 규칙입니다. ping은 되는데 SSH가 안 되면 대개 이겁니다. Peering 구간에서는 소스에 IP 대신 상대 보안그룹을 참조하는 방식이 확장에 강합니다.
에러 메시지를 구분해서 읽기. Network is unreachable은 클라이언트에 라우트가 없다는 뜻으로 Split Tunnel 문제입니다. Connection timed out은 보안그룹에서 드롭이 된 것입니다. Permission denied (publickey)는 연결 자체는 성공을 했고 키 문제입니다. 이 셋을 구분하면 디버깅 범위가 즉시 좁혀집니다.
지금 어디까지 왔나
솔직하게 적으면 이 대학 고객사 건은 PoC 단계에서 멈춰 있습니다. 요구조건 다섯 개를 두 가지 방식으로 각각 실증을 했고, Docker 랩에서 AWS로 승격해가지고 단일 IP 압축, 온프렘 무설치, 서버 추가 시 무설정, 인바운드 0을 전부 확인했습니다. 남은 건 고객사 측 게이트웨이 정보라든지 화이트리스트 등록인데, 그건 저희가 결정할 수 있는 영역이 아닙니다.
다만 같은 스택이 사내 다른 프로젝트에서는 실제로 돌아가고 있습니다. 내부 리소스 접근을 Cloudflare Zero Trust로 통제하는 형태입니다.
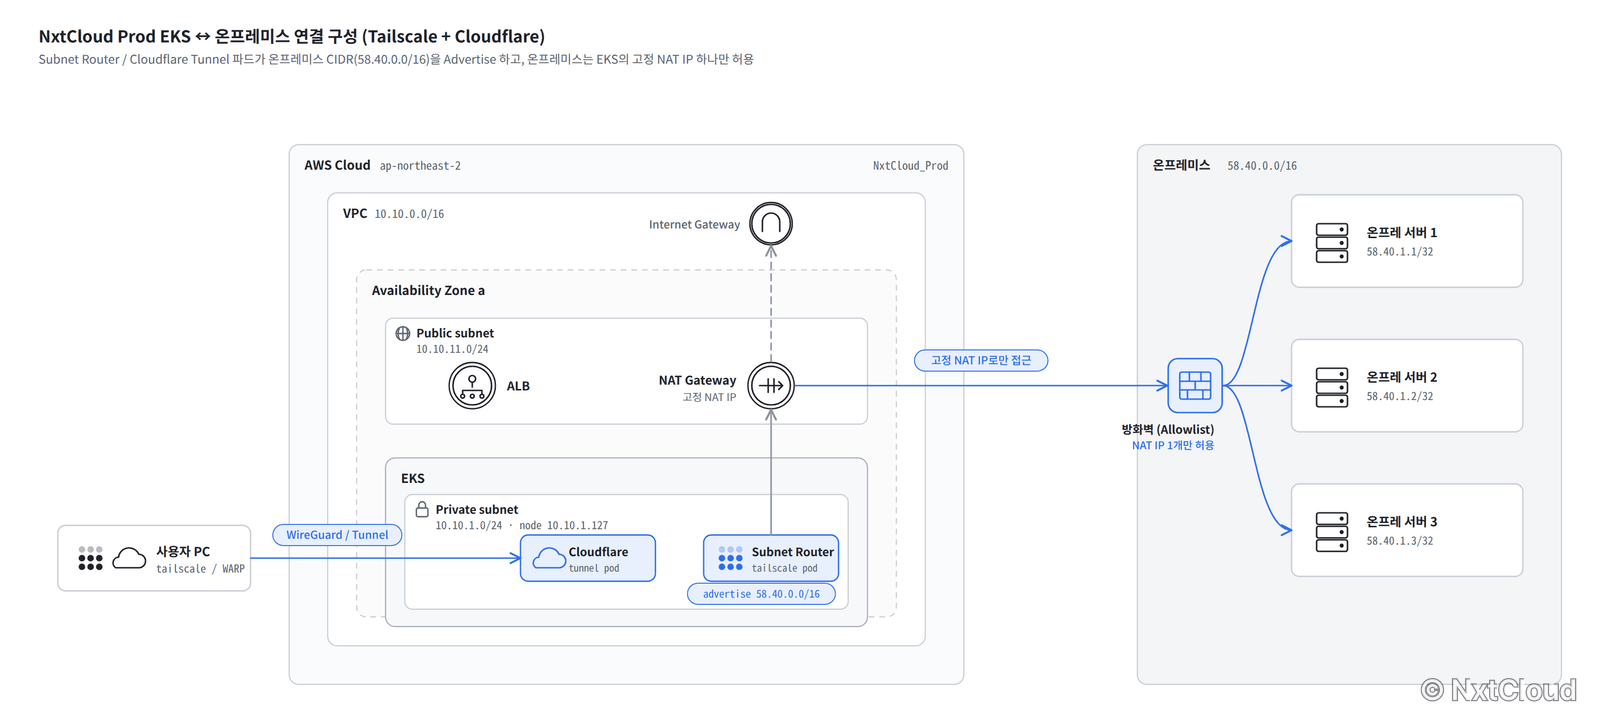 NxtCloud Prod EKS와 온프레미스 연결 구성. Subnet Router와 Cloudflare Tunnel 파드가 온프레미스 CIDR을 광고하고, 온프레미스 방화벽은 EKS의 고정 NAT IP 하나만 허용한다
이 구성에서 온프렘 방화벽은 EKS의 고정 NAT IP 하나만 허용을 합니다. 그 위의 인증은 Cloudflare의 사용자, 기기 신원이 맡고, 데이터 보호는 서비스 자체의 TLS라든지 SSH가 맡는 형태입니다. 앞에서 정리한 세 겹이 그대로 들어가 있는 셈입니다.
정리하면
서버까지 닿는 터널은 처음부터 만들 수가 없었습니다. 서버에 아무것도 설치하지 않기로 한 순간 정해진 부분이었거든요. 대신 터널은 저희 쪽 종단인 박스까지로 끊고, 그 뒤는 출발지를 하나로 압축하는 것이라든지 서비스가 이미 갖고 있는 암호화로 처리를 하게 되었습니다. 누가 언제 어디에 접근했는가는 네트워크가 아니라 Cloudflare의 신원 정책이나 로그 이런 쪽으로 넘기게 되었습니다. 온프렘이 보는 건 IP 하나, 저희가 보는 건 사용자 단위의 기록입니다.
온프렘 쪽이 확정이 되면 남은 갈래는 둘입니다. 고객사에 이미 VPN 게이트웨이가 있으면 저희 egress 게이트웨이가 그 터널에 붙게 됩니다. 고객사가 새로 설치할 건 없고, IPsec이면 IKE 버전, DH group, 암호 스위트, PFS, SA lifetime, traffic selector를, WireGuard면 공개키하고 엔드포인트, AllowedIPs 세 가지를 맞추는 협의만 남습니다. 이 협의 비용 차이가 두 프로토콜의 성격을 가장 잘 보여주는 지점이기도 합니다. 게이트웨이가 없으면 커넥터 박스 한 대를 고객사 DMZ에 두는 것으로 끝납니다. 커넥터는 아웃바운드로만 연결을 맺다 보니까, 이때는 방화벽에 IP를 등록할 필요조차 없어지게 됩니다.
어느 쪽이든 저희 설계는 같습니다. EKS 파드에서 egress 게이트웨이로, 거기서 SNAT를 거쳐서 단일 IP로 나가는 골격은 변하지 않고, 게이트웨이에서 돌리는 것만 strongSwan이나 wg나 cloudflared로 바뀌게 됩니다. 앞의 두 경우는 Docker 랩에서 통과를 시켜 뒀습니다.
여기까지가 저희가 단일 IP라는 제약 하나에서 시작해서 도구를 두 번 갈아탔던 과정이었습니다.
주석
[1] ZTNA(Zero Trust Network Access)는 "사내망 안에 있으면 신뢰한다"는 전제를 버리고, 접속마다 사용자와 기기의 신원을 확인한 뒤 허용된 리소스에만 연결해 주는 접근 방식입니다. 구현 형태로는 노드끼리 직접 붙는 mesh형(Tailscale)과 벤더의 엣지를 거치는 proxy형(Cloudflare)이 있고, 본문 뒷부분의 "mesh냐 proxy냐"가 이 구분입니다.
[2] 허브 앤 스포크(hub-and-spoke)는 모든 노드가 중앙의 허브 한 대에만 연결되고 노드 간 통신은 허브를 경유하는 구조입니다. 노드끼리 직접 연결하는 mesh와 대비됩니다. 이 글의 SNAT 박스가 바로 허브 자리입니다.
[3] X.509는 TLS 인증서의 표준 형식이고, CA(Certificate Authority)는 그 인증서에 서명해 신뢰를 보증하는 기관, CRL(Certificate Revocation List)은 폐기된 인증서 목록입니다. 일반적인 SSL VPN은 이 세 가지로 신원을 관리하는데, WireGuard는 공개키 한 줄로 대신합니다. 그래서 인증서 만료나 폐기 같은 운영 절차가 없지만, 반대로 키를 회수하려면 설정에서 직접 지워야 합니다.
[4] Noise IK는 Noise 프로토콜 프레임워크의 핸드셰이크 패턴 중 하나로, 개시자가 응답자의 정적 공개키를 미리 알고 있는 상황을 전제합니다. WireGuard는 이 패턴 하나만 지원하고 암호 스위트도 Curve25519, BLAKE2s, ChaCha20-Poly1305로 고정해 협상 단계를 아예 없앴습니다. 알고리즘을 바꿔야 하면 프로토콜 버전을 올리는 방식으로 대응한다는 설계입니다.
[5] IPsec 터널을 맺을 때 양쪽이 맞춰야 하는 값들입니다. IKE 버전(키 교환 프로토콜의 세대, v1/v2), DH group(키 교환에 쓰는 수학적 그룹의 크기), 암호 스위트(암호화·무결성 알고리즘 조합), PFS(세션 키가 유출돼도 과거 트래픽은 안전하게 하는 옵션), SA lifetime(키를 갱신하는 주기), traffic selector(어느 대역의 트래픽을 터널에 태울지). 하나라도 어긋나면 터널이 올라오지 않아서, 상대 조직과 표를 주고받으며 맞추는 작업이 IPsec 협의 비용의 대부분입니다.
[6] WireGuard는 리눅스 커널 모듈 구현과, Go로 작성된 사용자 공간 구현(wireguard-go)이 있습니다. 커널 구현은 패킷이 커널 안에서 처리되어 빠르고, 사용자 공간 구현은 이식성이 좋지만 컨텍스트 전환 비용이 있습니다. Tailscale은 모든 플랫폼에서 wireguard-go 기반으로 동작하므로, 본문 랩의 커널 WireGuard 처리량을 Tailscale 성능으로 바로 대입할 수는 없습니다.
[7] tc는 리눅스 커널의 트래픽 제어 도구이고, netem은 지연·지터·손실을 인위적으로 주입하는 모듈, tbf(token bucket filter)는 대역폭을 제한하는 모듈입니다. 본문 A 경로에서 tbf의 burst 32kbit는 100Mbps 기준 권장 하한(대략 rate/HZ, HZ=1000이면 약 12.5KB)보다 작아서 tbf 자체가 대역을 100Mbps 아래로 깎고 드롭을 더했을 가능성이 있습니다. 다만 RTT 91ms·손실 0.5% 조건에서 TCP 처리량 상한을 계산하면 수 Mbps 수준이 나오므로, 실측 5.24Mbps는 tbf와 무관하게 long fat network 효과만으로도 설명됩니다. 재현하실 때는 burst 1600kbit 이상으로 두시길 권합니다.
[8] ping 출력의 mdev는 RTT 표본의 표준편차입니다. 엄밀한 의미의 지터(연속 패킷 간 지연 차이)와는 정의가 다르지만, 경로의 지연 흔들림을 보는 간편한 지표로 흔히 대용합니다. 본문에서는 이 뜻으로 썼습니다.
[9] long fat network는 대역폭과 지연의 곱(BDP, bandwidth-delay product)이 큰 경로를 말합니다. TCP 처리량의 상한은 대략 윈도 크기를 RTT로 나눈 값이라, 지연이 크면 윈도가 충분히 커져야 대역을 다 씁니다. 여기에 패킷 손실이 섞이면 혼잡 제어가 윈도를 반복적으로 줄이면서 계약 대역과 무관하게 처리량이 주저앉습니다.
[10] DERP(Designated Encrypted Relay for Packets)는 Tailscale이 운영하는 릴레이입니다. 양쪽 모두 대칭 NAT 뒤에 있는 등의 이유로 직접 연결이 안 될 때 폴백 경로로 쓰이며, WireGuard로 암호화된 페이로드만 중계하므로 릴레이가 내용을 볼 수는 없습니다. 다만 경로에 홉이 하나 더 붙으므로 지연은 늘어납니다.
[11] 100.64.0.0/10은 RFC 6598이 통신사 등급 NAT(CGNAT)용으로 예약한 공유 주소 공간입니다. 사설 대역이나 공인 대역과 충돌할 가능성이 낮아 Tailscale이 tailnet 노드 주소로 씁니다. 이 대역은 변경할 수 없으므로, 광고하는 온프렘 대역과는 별개의 층으로 이해해야 합니다.
[12] --advertise-routes만으로는 끝나지 않습니다. 라우터 호스트에서 IP 포워딩(net.ipv4.ip_forward=1)을 켜야 하고, 광고된 대역은 Tailscale 관리 콘솔에서 승인(approve)해야 다른 노드에 배포됩니다. 승인을 자동화하려면 ACL의 autoApprovers를 쓰면 됩니다.
[13] WARP의 Split Tunnel은 단말에서 어떤 트래픽을 Cloudflare로 보낼지 정하는 설정입니다. Exclude 모드는 "이 대역만 빼고 전부 터널로", Include 모드는 "이 대역만 터널로"입니다. 본문처럼 온프렘 대역만 Cloudflare를 거치게 하려면 Include 모드에 그 대역을 넣습니다.
[14] 두 서비스의 무료 티어 인원은 정책이 바뀔 수 있는 값입니다. 도입 시점에 각 벤더의 요금제 페이지에서 다시 확인하시는 게 좋습니다.
[15] RFC 6528(Defending against Sequence Number Attacks)은 TCP 초기 시퀀스 번호를 비밀 키와 해시로 생성하도록 권고하며, 현대 리눅스·BSD·Windows가 모두 이를 따릅니다. 인터넷 사업자들이 위조 출발지 패킷을 걸러내는 BCP38 이그레스 필터링도 블라인드 스푸핑을 어렵게 만드는 또 한 겹입니다.
[16] 1994년 케빈 미트닉이 츠토무 시모무라의 시스템에 침입할 때 쓴 방식이 TCP 시퀀스 번호 예측을 이용한 블라인드 스푸핑이었습니다. 당시 구현은 시퀀스 번호가 일정 규칙으로 증가해 추측이 가능했습니다.
[17] 2018년 4월 Amazon Route 53의 주소 대역이 BGP 하이재킹으로 약 두 시간 납치되어 MyEtherWallet 사용자 트래픽이 공격자 서버로 유도된 사건이 대표 사례입니다. 경로를 통제하는 공격자에게는 출발지 IP 검사가 아무 보장을 하지 못합니다.
[18] WireGuard 백서의 "stealth" 설계 원칙입니다. 핸드셰이크 첫 메시지부터 상대 공개키로 인증되며, 인증되지 않은 패킷에는 어떤 응답도 보내지 않아 포트 스캔으로 존재를 확인할 수 없습니다.
[19] 이 글을 작성한 시점의 Cloudflare 문서 기준입니다. Gateway 정책의 프로토콜 지원 범위는 바뀔 수 있으니, 같은 증상을 만나면 현재 문서를 먼저 확인하시길 권합니다.
참고
- WireGuard: Next Generation Kernel Network Tunnel (백서)
- Subnet routers, Tailscale
- Connect private networks with cloudflared, Cloudflare
- AWS Site-to-Site VPN 사용 설명서
- RFC 6598, IANA-Reserved IPv4 Prefix for Shared Address Space
- tc-netem(8), tc-tbf(8) man pages
- RFC 6528, Defending against Sequence Number Attacks
- BCP 38 / RFC 2827, Network Ingress Filtering
- Site-to-site networking, Tailscale
- Cloudflare Gateway dedicated egress IPs
이 글의 수치와 구성은 실제 PoC 과정에서 확인한 것입니다. 고객사 식별 정보와 실제 공인 IP는 익명화했고, 본문에 등장하는 내부 대역은 사설 주소입니다.